论文精读|ACT:用动作分块学习双臂精细操作
论文: Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware
作者: Tony Z. Zhao、Vikash Kumar、Sergey Levine、Chelsea Finn
发表: RSS 2023;arXiv 首次提交于 2023 年 4 月 23 日
方法: Action Chunking with Transformers(ACT)论文 · 项目主页与演示视频 · ACT 代码 · ALOHA 硬件与采集代码
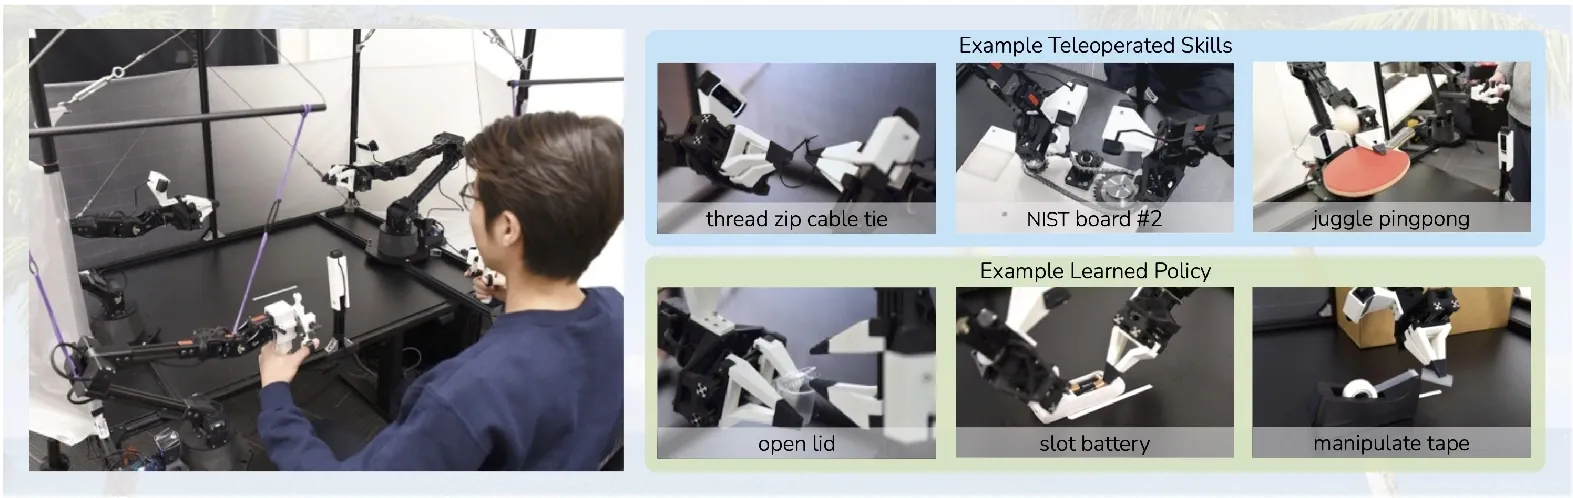
把电池放进遥控器,看起来只是一次插入,实际却需要两只手配合:一只手压住遥控器,另一只手把电池的一端送入槽内,再抵住弹簧,把另一端压下去。位置差几毫米,或者压住遥控器的时机稍晚,后续动作就可能全部失效。
ACT 关心的正是这类操作。它用 ALOHA 收集双臂示范,再让策略根据相机图像和关节位置,一次预测一段未来动作。执行时,策略持续接收观测,并融合不同轮次对当前时刻的预测。训练中再引入条件 VAE,处理人类示范里不同的动作路径和节奏。
封面来自原论文 Figure 1。右上方展示的是人类遥操作能力,右下方才是学习策略的示例;两者对应的能力范围需要区分。
为什么单步行为克隆容易在精细操作中失手?
行为克隆(Behavior Cloning,BC)把模仿学习写成一个监督学习问题:从专家示范中收集观测与动作,学习在当前观测下应该执行什么动作。
设观测为 ,专家动作为 ,常见的单步策略可以写成:
问题出在训练和部署看到的状态并不完全相同。训练时,模型面对的是专家走过的轨迹;部署时,它必须接着自己上一步造成的状态往下走。如果第一次抓取偏了一点,物体的位置和姿态就会变化,后面的策略输入也随之偏离示范。预测误差继续累积,机器人可能进入训练数据没有覆盖、自己也不会纠正的状态。这就是模仿学习中的误差累积问题。
在装电池、穿扎带、撬开杯盖这些任务里,误差尤其容易被接触放大。夹爪只是稍微碰偏了物体,物体就可能旋转、滑动或变形。即使单帧动作预测的误差不大,整段任务也未必能完成。
另一个困难来自示范本身。人不会在每次演示里都保持完全相同的速度、停顿和交接位置。例如,递交胶带时,两只夹爪可以在多个位置完成交接;只看一张图像,也未必能判断演示者准备继续移动还是短暂停顿。把每一帧都当成独立的回归样本,会丢掉动作之间的连续关系。
论文由此提出两个相互关联的问题:能否让模型直接学习一段协调的动作,减轻逐步决策的负担?能否同时容纳人类示范中合理的路径与节奏差异?
ALOHA:先把示范采集这件事做好
这篇论文同时提出了硬件系统 ALOHA 和学习算法 ACT。ALOHA 负责让人方便地操作机器人、记录示范;ACT 负责从这些示范中学出视觉控制策略。
ALOHA 使用两套双臂配置。操作者直接拖动较小的 leader 机械臂,执行任务的 follower 机械臂通过关节空间映射跟随运动。系统还改造了示教手柄、夹爪和重力补偿结构,让操作者更容易连续控制夹爪开合,并完成细小的接触动作。论文报告,整套系统的成本控制在 2 万美元以内;这是论文当时的系统成本口径。
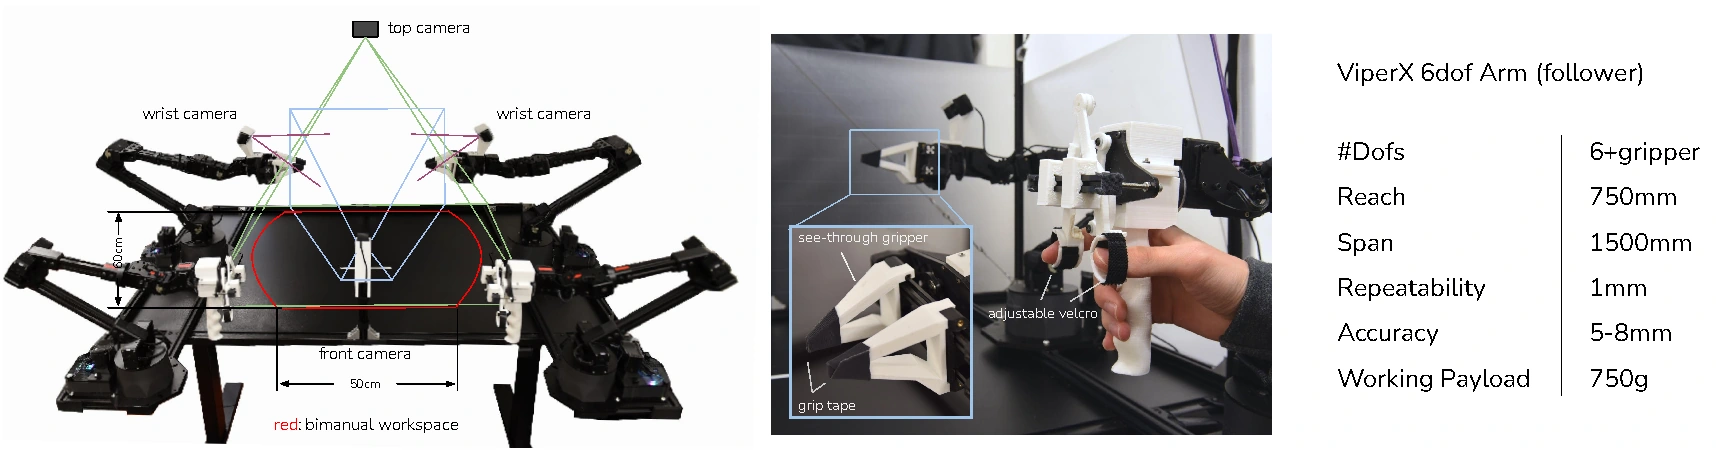
策略使用四路 RGB 图像和 follower 当前的关节位置作为观测:
其中 。每只机械臂有 6 个关节和 1 个夹爪控制量,两侧合计 14 维。动作也是 14 维,表示双臂下一步的绝对目标关节位置,由底层控制器负责跟踪。
这里有一个值得保留的采集细节:动作标签来自 leader 的关节位置,观测中的关节位置来自 follower。 两者承担不同角色。leader 表达操作者希望机器人到达的位置,follower 记录机器人实际到达的位置。在接触过程中,两者的偏差会通过底层 PID 控制器影响施加的力,因此不能直接把 follower 的实际位置当成全部动作标签。
ALOHA 的控制与数据记录频率为 50 Hz,即每个控制周期约 20 ms。论文附录还说明相机视频流为 30 fps,所以 50 Hz 控制并不意味着每个控制周期都有一张全新的相机帧。
这套系统没有给策略提供物体位姿真值或显式的环境动力学模型。模型需要从图像和自身状态中学会怎样接近物体、建立接触,再根据变化调整动作。
动作分块:一次预测未来的一段动作
ACT 把单步动作预测改成动作序列预测。为避免区间端点的歧义,下面把长度为 的动作块记为:
每个动作是 14 维,因此 。相应的策略变为:
其中 是训练时引入的潜变量,后面再解释。先忽略它,动作分块的含义就是:模型在看到当前观测后,同时预测接下来多个控制周期的目标位置。
动作块为什么有帮助?
最直接的执行方式是每隔 步观察一次,然后依次执行预测出的 个动作。对于长度为 的任务,策略生成动作块的次数由大约 次减少到 次。论文把它描述为有效决策时域的缩短。
例如,若 、控制频率为 50 Hz,一个动作块覆盖约 2 秒。模型可以在一次预测中组织“靠近电池槽、调整角度、开始压入”这样的连续运动,训练目标也会直接约束这段动作之间的关系。
这里的 对应按整块执行时的决策次数,实际控制周期并没有变少。动作分块仍然依赖示范覆盖,预测出的序列也可能偏离真实环境,不能由决策次数的减少直接推导成功率的提升幅度。
动作块还能在一定程度上容纳人类示范中的停顿和节奏。模型学习的是一段运动模式,某几帧停住、随后继续的关系可以出现在同一个预测目标中。不过,它不能因此解决所有依赖长历史的部分可观测问题。
时序集成如何让机器人持续利用新观测?
整块执行有一个明显代价:块内缺少新的视觉修正,而且切换动作块时可能突然改变运动方向。精细操作恰恰需要持续调整,因此 ACT 在推理时引入时序集成(Temporal Ensembling)。
启用时序集成后,策略在每个控制步重新预测一个动作块。这样,相邻的动作块会相互重叠。假设当前是第 步,刚刚生成的动作块包含对 的预测,上一轮生成的动作块也包含对 的预测,更早的若干轮同样如此。ACT 收集这些都指向当前执行时刻的动作,再加权得到最终命令。
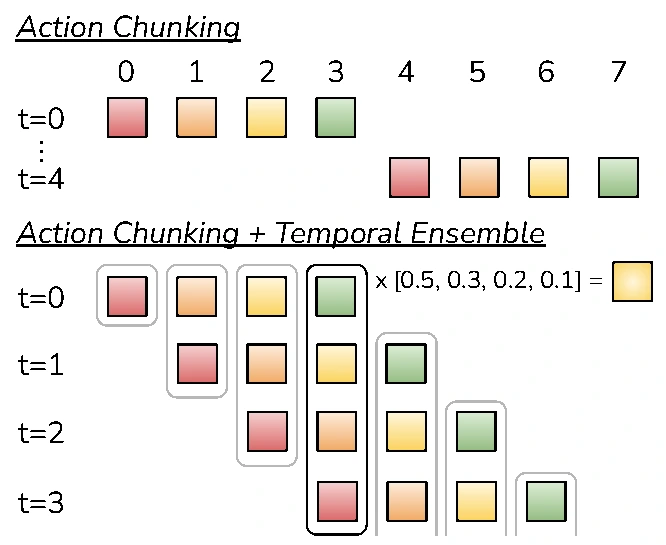
记 为第 步生成、计划在第 步执行的动作,当前有效预测的生成时刻集合为:
将这些预测按生成时间从早到晚排列为 ,集成后的动作可以写成:
权重采用指数形式 ,其中 为控制权重衰减的超参数。
参与平均的动作都对应同一个执行时刻。 如果把已经执行的 和准备执行的 混在一起平滑,就改变了原来的时间对应关系,也不是论文这里使用的方法。
权重方向也容易看反。原文明确规定 对应最早生成的预测,所以在 时,较早预测的权重更大。减小 会让新旧预测的权重更接近,使新观测更快影响执行结果。官方推理代码也按这个顺序计算指数权重。阅读其他实现时,需要同时检查缓存顺序和指数公式。
因此,启用时序集成后,ACT 仍会每步查询策略;分块的作用体现在连续动作的联合预测上。时序集成则在推理阶段协调重叠预测,改善运动连续性,同时带来额外的推理计算。
条件 VAE:怎样学习不完全一致的人类示范?
在空中交接胶带时,操作者可以在偏左或偏右的位置完成交接。只要两只手配合得当,这些轨迹都可能成功。但如果只对不同示范做确定性的逐元素回归,模型可能学到一个并不对应完整示范的折中序列。
ACT 将动作块建模为条件 VAE(Conditional Variational Autoencoder,CVAE)。模型由训练时使用的后验编码器和真正输出动作的策略网络组成。
训练时,用潜变量表示示范的差异
训练时,编码器可以看到当前关节位置 和专家未来动作块 ,输出一个对角高斯分布:
这里的 和 都由 与 决定。为了减少训练计算,论文中的这个后验编码器不接收图像。它通过重参数化采样潜变量:
随后,策略根据当前完整观测和 重建专家动作块:
论文把 称为动作序列的“风格变量”。它用于容纳示范中路径、节奏等差异;这些含义由训练形成,论文没有为潜变量的每一维指定可解释的控制语义。
训练损失包含动作重建和 KL 正则两部分:
这里为简洁起见,将后验 缩写为 。重建项要求预测动作贴近示范,KL 项把后验分布约束到标准高斯先验附近。 控制两者的相对权重;论文默认设为 10。按作者的解释,更大的 会限制 携带的信息量。
这里的重建项使用 L1。原论文 Algorithm 1 的伪代码写的是 MSE,但第 IV-C 节明确说明实际实现采用 L1,并报告它更有利于精确建模动作序列。理解方法和复现时,应注意这处正文与伪代码的差异。
推理时,把潜变量固定为零
部署时没有专家未来动作,后验编码器无法继续使用。ACT 将它移除,把潜变量设为先验均值:
因此,论文中的标准推理流程是确定性的,不需要每次从潜变量分布随机采样。CVAE 在这里首先是一种训练动作模型、处理示范差异的方法;不能仅凭使用了生成模型,就认为部署时会主动探索多条轨迹。 对应先验均值,也不意味着输出一定是概率最高的动作序列。
Transformer 具体怎样生成动作块?
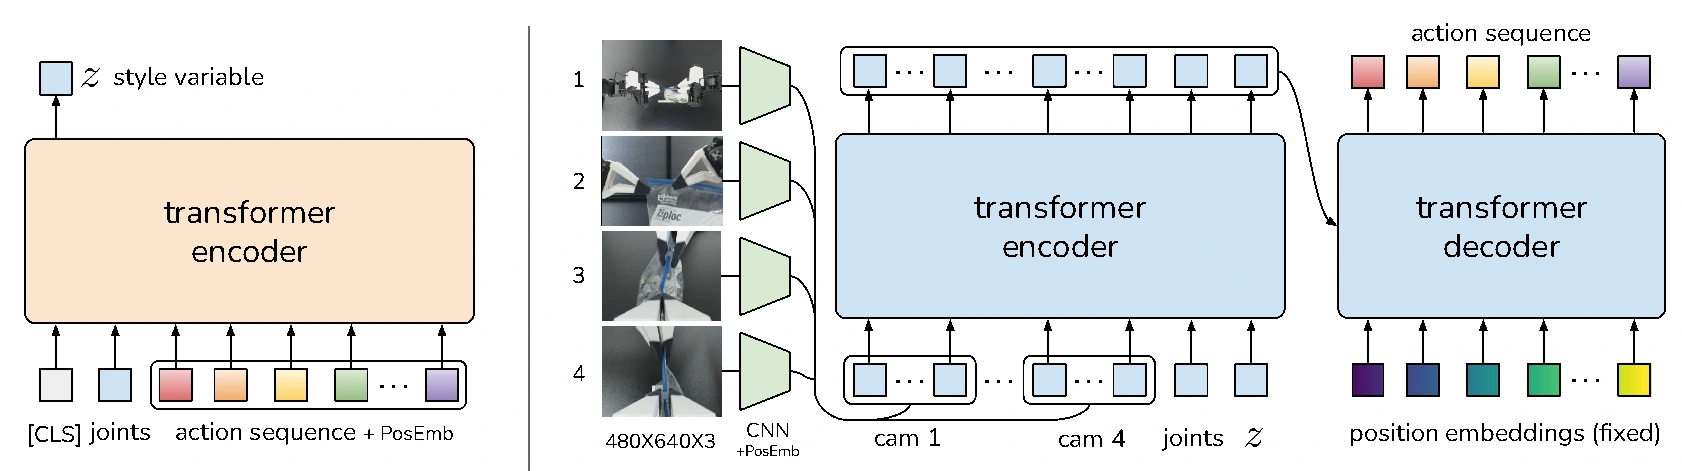
ACT 里有两层容易混淆的“编码器与解码器”。CVAE 的编码器负责推断 ,CVAE 的解码器就是动作策略;而这个动作策略内部,又包含视觉骨干、Transformer encoder 和 Transformer decoder。
先看训练专用的后验编码器。它把一个可学习的 [CLS] token、当前关节位置,以及长度为 的动作序列映射到特征空间,组成 个 token。Transformer 处理后,取 [CLS] 对应的输出预测 的分布参数。
动作策略则按下面的过程处理观测:
| 环节 | 论文中的输入与输出 | 作用 |
|---|---|---|
| 图像编码 | 每路 RGB 图像,经 ResNet18 得到 特征图 | 提取各相机视角的视觉信息 |
| 视觉序列 | 每路展平为 ,四路共 ,加入二维位置编码 | 保留图像内的空间位置信息 |
| 状态与潜变量 | 关节位置和 分别投影为 512 维 token | 提供机器人状态和动作风格条件 |
| Transformer encoder | 共 的输入特征 | 融合多视角视觉、关节状态与潜变量 |
| Transformer decoder | 个动作位置查询,通过交叉注意力读取融合特征 | 同时生成未来 个动作位置的表示 |
| 动作输出头 | 得到双臂绝对目标关节位置 |
这些动作查询分别对应未来序列中的不同位置。模型可以一次输出整个动作块,无需先生成第一个动作,再把它作为输入逐个生成后续动作。
论文附录 Table III 给出的主要超参数如下:
| 参数 | 设置 |
|---|---|
| 动作块长度 | 100 |
| 隐藏维度 | 512 |
| Transformer encoder 层数 | 4 |
| Transformer decoder 层数 | 7 |
| 注意力头数 | 8 |
| 前馈网络维度 | 3200 |
| 学习率 / batch size | / 8 |
| KL 权重 / dropout | 10 / 0.1 |
原文报告模型约有 8000 万参数,每个任务单独训练;在单张 RTX 2080 Ti 上训练约需 5 小时,单次推理约 0.01 秒。这些是作者在特定设置下测得的运行开销,迁移到其他设备时仍需要实测。
项目主页演示视频注明固定动作块长度为 90,论文附录的默认值则是 100。两处对应各自的实验或演示设置,引用参数时应注明来源。
实验结果:六个真实任务的难度并不相同
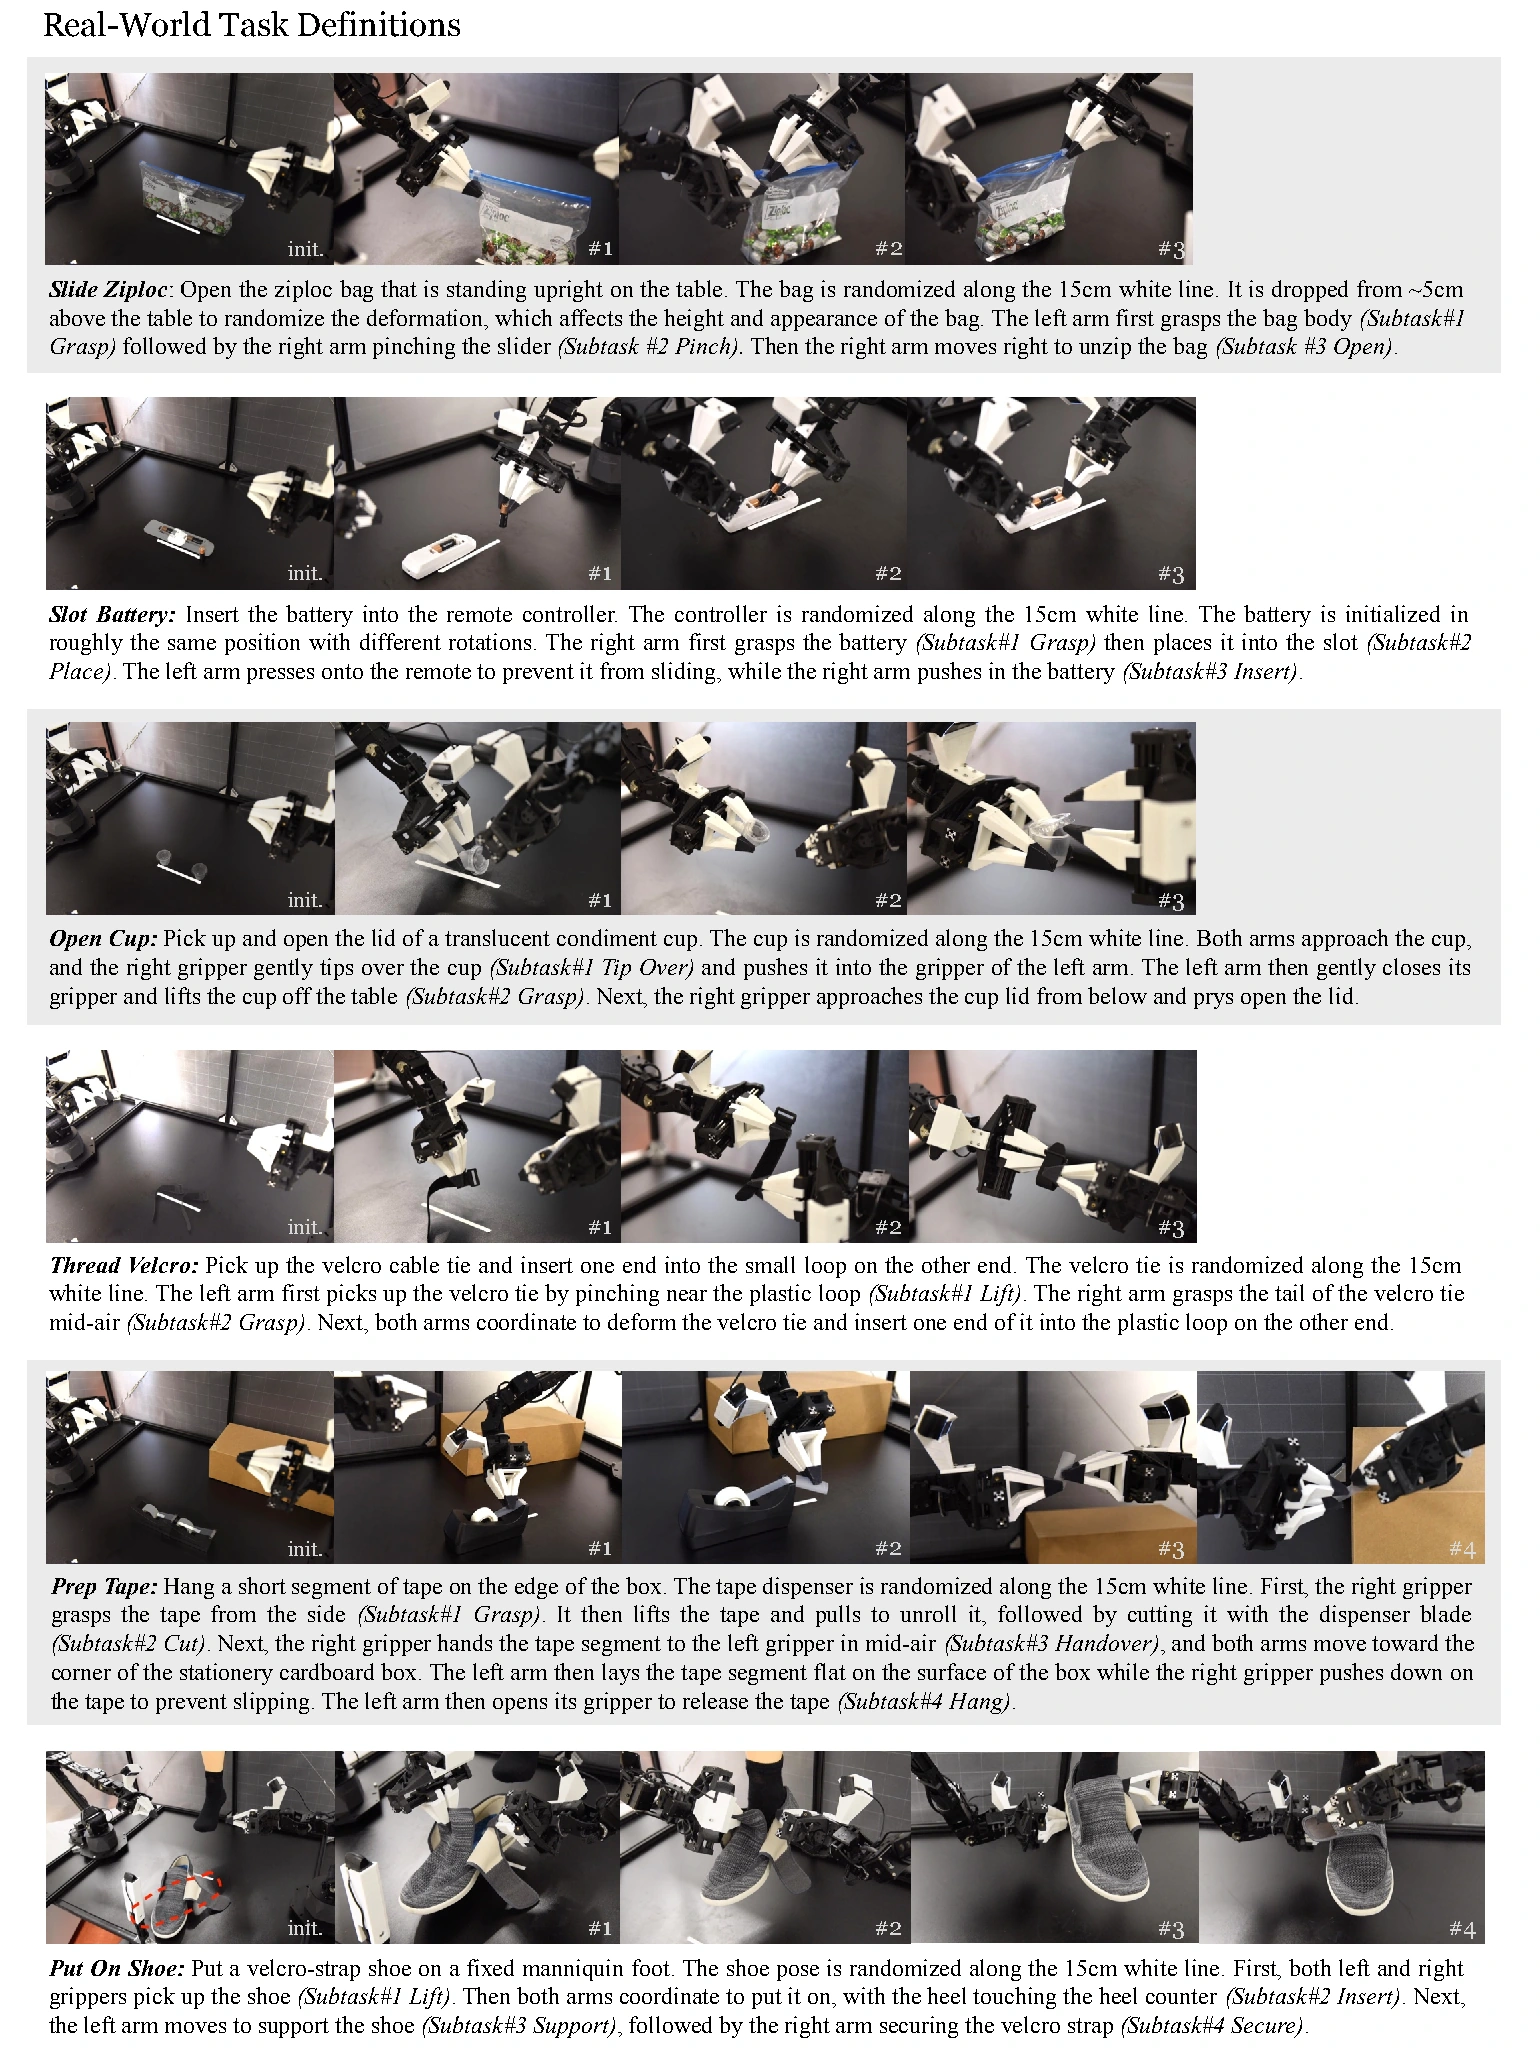
论文评估了六个真实世界任务和两个 MuJoCo 仿真任务。真实任务涉及拉开密封袋、装电池、开调料杯盖、穿魔术贴扎带、处理胶带和穿鞋,很多步骤都要求双臂在接触中配合。
训练数据和评估口径
每个真实任务通常收集 50 条示范,Thread Velcro 使用 100 条。单条示范约 8–14 秒,对应 400–700 个控制步。论文将每项任务的示范总量概括为约 10–20 分钟;如果计入环境复位和操作者失误,实际采集约需 30–60 分钟。
所以,“约十分钟示范”描述的是记录下来的演示数据量,不能当成完整的采集或训练耗时。论文也没有证明所有任务都能靠完全相同的数据量学会。
真实实验中,物体初始位置主要沿桌面的 15 cm 参考线变化;仿真任务在指定二维区域随机初始化。这些设置能够检验一定范围内的初始状态变化,但没有覆盖任意新物体、房间或相机布置。
真实任务使用 1 个训练随机种子,每项评估 25 次;仿真任务使用 3 个种子,每个种子评估 50 次。阅读成功率时,需要连同这些样本量和环境条件一起看。
真实任务:装电池 96%,穿扎带仍只有 20%
下面只取 Table I、II 中最后一个子任务的成功率,表示完整任务的完成情况:
| 任务 | 示范条数 | ACT 完整任务成功率 | BeT 完整任务成功率 |
|---|---|---|---|
| Slide Ziploc:拉开密封袋 | 50 | 88% | 0% |
| Slot Battery:装入电池 | 50 | 96% | 0% |
| Open Cup:打开调料杯盖 | 50 | 84% | 0% |
| Thread Velcro:穿魔术贴扎带 | 100 | 20% | 0% |
| Prep Tape:取下一段胶带并挂在盒边 | 50 | 64% | 0% |
| Put On Shoe:穿鞋并固定魔术贴 | 50 | 92% | 0% |
前两个真实任务还比较了 BC-ConvMLP、RT-1 和 VINN,它们的最终成功率也均为 0%。其余四个任务只与 BeT 比较。这里的 RT-1 指论文在该数据与任务设置下训练、评估的基线,结果不能直接外推到 RT-1 在其他数据规模下的能力。
这些结果说明,ACT 在论文设置的精细双臂任务上明显优于所比较的方法,同时也暴露出任务之间的差距。Thread Velcro 的阶段成功率从抬起扎带的 92%,降到空中抓取的 40%,最终穿入只剩 20%。作者观察到的失败包括右夹爪过早闭合、没抓住扎带尾部,以及插入位置不准。
黑色扎带与桌面背景对比度低,在图像中占据的区域也小。即使采用动作分块,如果视觉输入不能准确支持接触判断,后续序列仍然容易失败。
仿真任务:人类示范与脚本示范要分开看
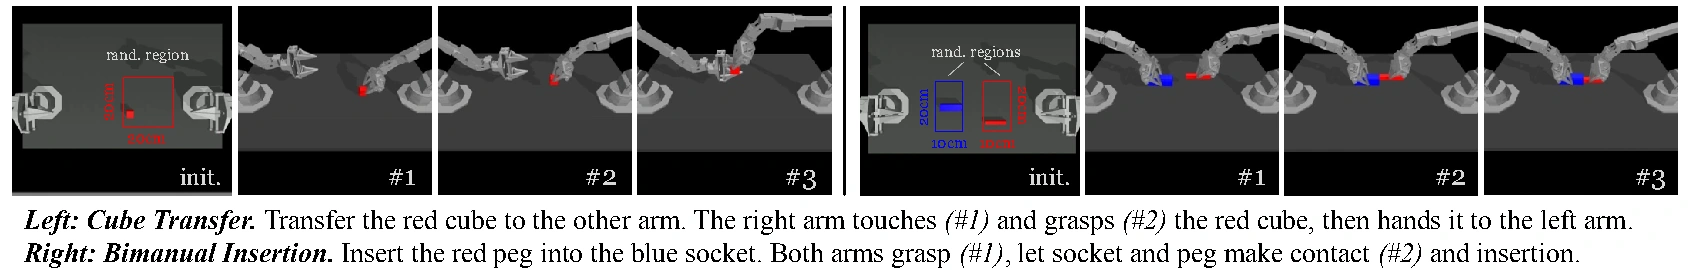
论文为每个仿真任务分别准备了脚本示范和人类遥操作示范,每种各 50 条。下表同样只保留完整任务成功率:
| 方法 | Cube Transfer:脚本 / 人类 | Bimanual Insertion:脚本 / 人类 |
|---|---|---|
| BC-ConvMLP | 1% / 0% | 1% / 0% |
| BeT | 27% / 1% | 3% / 0% |
| RT-1 | 2% / 0% | 1% / 0% |
| VINN | 3% / 0% | 1% / 0% |
| ACT | 86% / 50% | 32% / 20% |
ACT 在这些对比中表现最好,但双臂插入仍然困难。从脚本数据换成人类数据后,ACT 的成功率也下降了。数据中存在更多路径和节奏变化时,模仿学习的难度会增加;“使用人类示范”并不会自动带来更高的策略成功率。
消融实验:哪些设计真正贡献了收益?
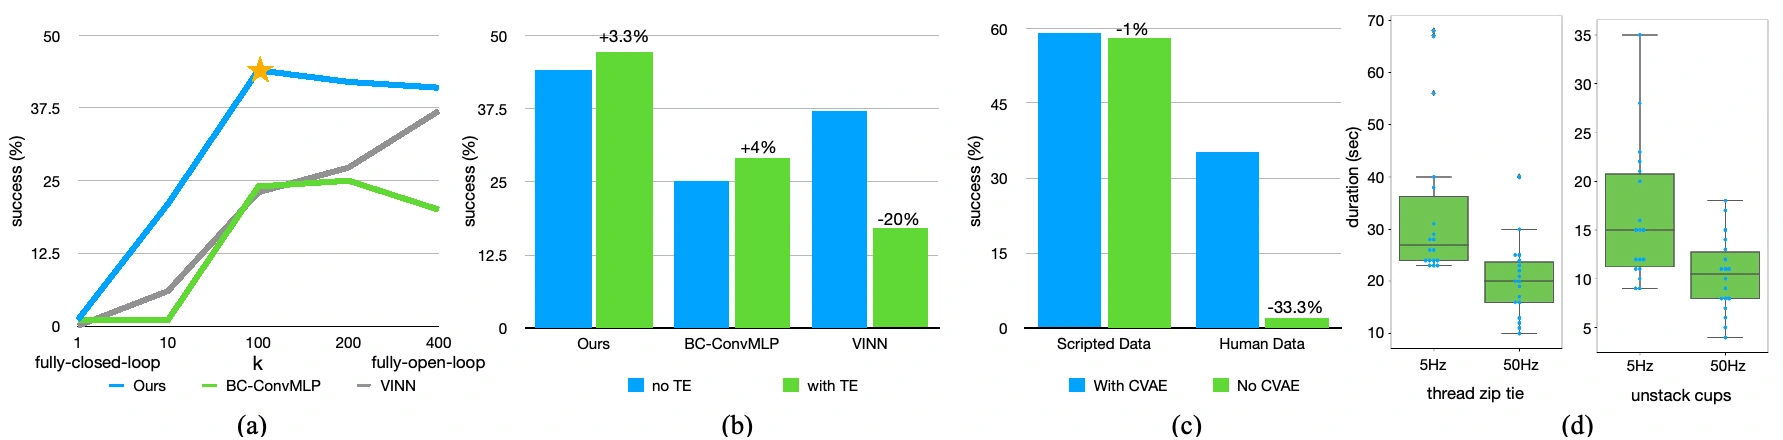
动作分块的收益最直接。为单独考察分块,作者关闭时序集成,并在“两个仿真任务 × 两种示范来源”共四个设置上取平均。ACT 的平均成功率随 变化如下:
| 动作块长度 | 1 | 10 | 100 | 200 | 400 |
|---|---|---|---|---|---|
| 平均成功率 | 1% | 21% | 44% | 42% | 41% |
从单步预测改到长度为 100 的动作块,收益很大;继续增加长度则没有进一步提升。作者将后面的回落归因于反馈减少,以及长序列更难建模。BC-ConvMLP 和 VINN 加上动作分块后也有提升,说明收益并非只能由 Transformer 获得。
时序集成的作用更有限,也更依赖方法。在论文分别调参后比较的设置中,ACT 的平均成功率从 44% 提升到 47.3%,增加 3.3 个百分点;BC-ConvMLP 从 25% 到 29%。VINN 则从 37% 降至 17%。因此,时序集成不能被当成对所有策略都有效的通用补丁。作者认为参数化模型可能从预测误差的平滑中获益,而直接检索示范动作的 VINN 未必有同样的收益,这仍属于对实验现象的解释。
CVAE 消融回答的是另一个问题。在两个仿真任务上汇总结果后,脚本数据训练的成功率在去掉 CVAE 时只从 59% 变为 58%;人类示范训练则从 35.3% 降至 2%。这支持 CVAE 在该实验中处理人类示范差异的作用。它没有进一步证明究竟是哪一种示范变化造成了主要困难,也不能说明每个数据集都会出现同样幅度的收益。
图中最后一项是人类遥操作用户研究。6 名参与者分别在 5 Hz 和 50 Hz 下完成穿扎带、分开套叠杯子两个任务,降低频率后,完成时间总体增加约 62%。这个结果支持高频反馈对这些精细操作的价值,但它测量的是人的遥操作表现,没有直接给出 ACT 在所有控制频率下的成功率曲线。
ACT 的边界,以及值得带走的设计思路
ACT 的效果依赖于示范质量、感知能力和硬件条件。它没有通过动作分块消除分布偏移,也没有让双指夹爪具备任意精细操作能力。
论文报告,ALOHA 对需要多指配合、大力矩或类似指甲动作的任务仍然受限。例如,夹爪难以完成某些需要一边按压一边旋开的瓶盖操作,低成本电机也难以支持较大的接触力。这些限制不能单靠换一个动作模型解决。
学习本身也有失败案例。作者尝试用 50 条示范学习拆糖果包装,初步的 10 次测试中,策略能全部抓起糖果,却没有一次成功完全拆开。它经常在不存在包装接缝的位置尝试剥开。把评估放宽为每颗糖果最多尝试 10 次后,5 颗中成功拆开了 3 颗,这与单次尝试的成功率是不同的评估口径。另一个任务是打开平放的小密封袋:策略能够捡起袋子,却难以稳定完成后续空中操作。作者将这些困难与感知、数据不足及物体形变联系起来,并提出预训练、更多数据和更好的感知可能有帮助;这些方向在本文中尚未得到验证。
从这些结果看,ACT 值得借鉴的地方,是把高频控制中的连续动作组织成一个合适的学习目标:动作块约束一段运动的内部关系,CVAE 训练目标容纳示范差异,时序集成协调反复生成的预测。三项设计各自解决的问题不同,消融结果也显示它们的收益并不相同。
如果要复现或迁移 ACT,动作的定义和数据对应关系需要先核对清楚:输入是机器人实际状态,输出是绝对目标关节位置;训练时的后验编码器能看到未来示范动作,部署时要移除它并令 ;动作块长度决定预测范围,查询频率决定何时使用新观测;时序集成必须对齐到同一个执行时刻。这些细节会直接改变控制行为。
ACT 给出的证据是,在有限数据、特定硬件和任务范围内,学习连续动作块可以比逐帧动作预测更有效地完成精细操作。读到“约十分钟示范”和“80–90% 成功率”时,再回到具体任务、采集时间、测试次数和失败阶段,才能判断这个结果对自己的任务有多大参考价值。
原文与配图来源
本文依据所提供的 ACT.pdf(arXiv:2304.13705v1)撰写,实验数据对应原论文 Table I–III 与 Figure 8;封面及正文配图均从该 PDF 截取,仅裁去图外空白与英文图注,图内内容未改写。图片与原始研究成果归原作者所有。
- 原论文与版本信息:方法、实验和附录细节的主要来源。
- 作者项目主页:RSS 2023 信息、任务视频与动作块长度为 90 的演示设置。
- ACT 官方代码仓库:训练和推理实现,时序集成见
imitate_episodes.py。 - ALOHA 官方代码仓库:硬件使用、遥操作与数据采集相关实现。