论文精读|DP3:当 Diffusion Policy 遇上 3D 点云
论文: 3D Diffusion Policy
作者: Yanjie Ze、Gu Zhang、Kangning Zhang、Chenyuan Hu、Muhan Wang、Huazhe Xu
发表: RSS 2024;首次公开于 2024 年 3 月 6 日
本文对应的 arXiv v1 · 现行论文 · 代码 · 项目与演示视频
版本说明:本文依据 2024 年 3 月 6 日的 arXiv v1 解读,实验表中的“相对提升 55.3%”来自该版 Table I。v7 摘要报告的是 24.2%,下文保留 v1 的实验口径,不混用两版数字。
DP3 想解决的问题是:示范很少时,策略能否更容易学到“物体在哪里、机器人该往哪里动”?它保留了 Diffusion Policy 生成动作序列的方式,把视觉输入换成稀疏点云,再用一个小型编码器提取几何特征。这个改动把一部分原本需要从像素中学习的空间关系,放进了输入表示里。
但“给策略加上深度”还不足以解释它的效果。论文里,深度图、RGB-D 和体素都弱于点云;换成更复杂的点云编码器,成绩甚至会明显下降。因此,DP3 真正值得研究的是:怎样把三维观测压缩成适合控制的条件,以及实验能否把表示、编码器和动作模型的作用区分开。
从一张深度图到一段动作,DP3 做了什么?
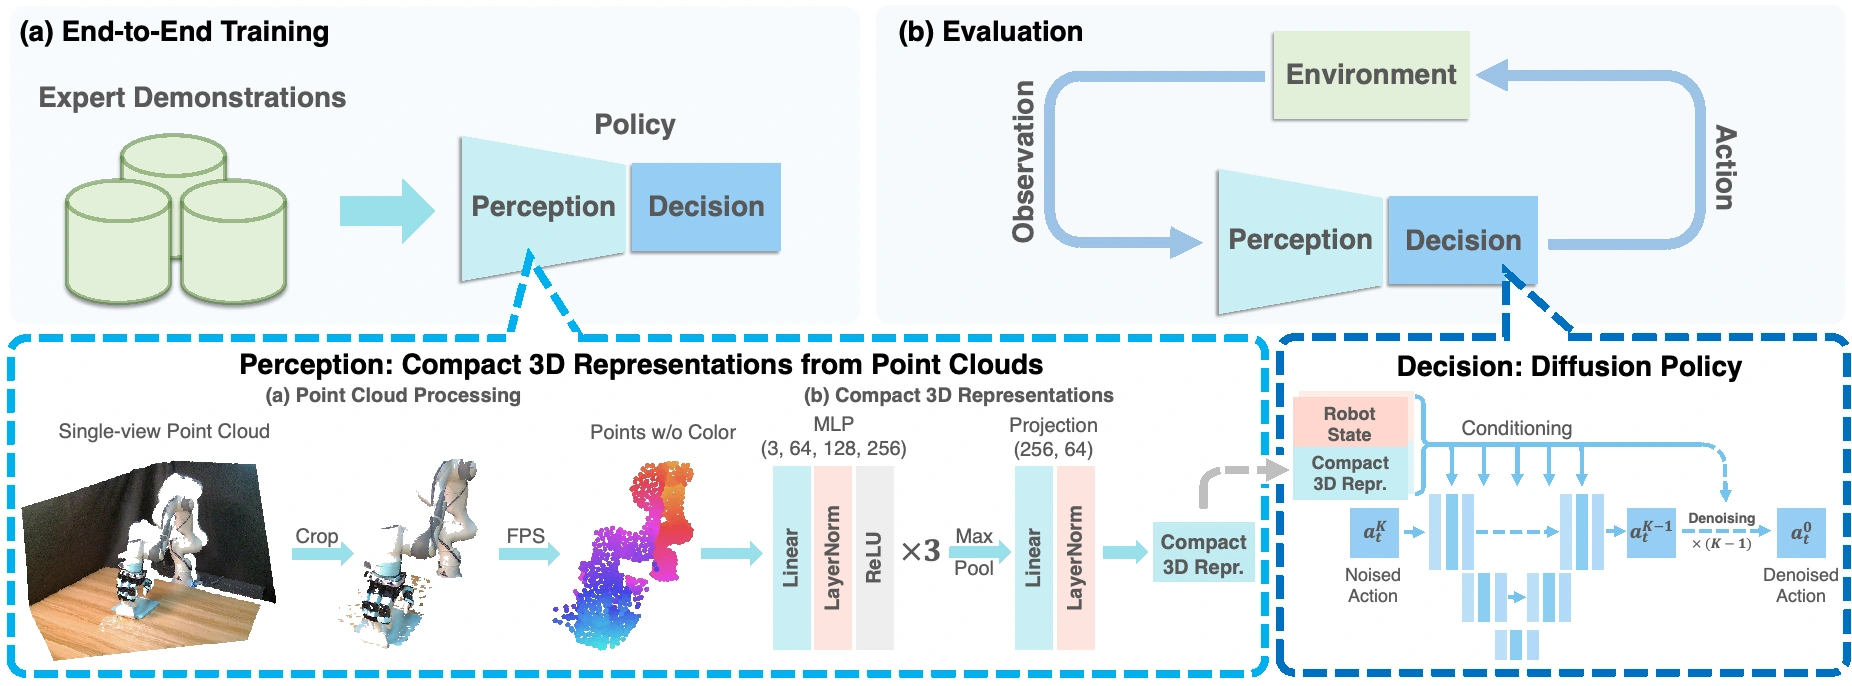
一次策略查询可以分成两个映射:先把点云和机器人状态编码成条件,再根据这个条件生成动作块。记点云为 、机器人自身状态为 ,则有:
其中,点云特征 和状态特征 都是 64 维。策略使用两个观测时刻的条件信息,从随机噪声中生成一个动作序列。这里的扩散模型生成的是机器人动作;点云本身只经过确定性的预处理与编码。
这种拆法也划清了贡献范围:DP3 的感知模块负责提供几何条件,动作模块沿用基于卷积网络的 Diffusion Policy。它没有额外学习物体动力学,也不需要先预测关键帧位姿、再交给运动规划器完成整段运动。
点云预处理承担了哪些工作?
论文在仿真和真实实验中都使用单视角、 的深度观测,结合相机内外参转换为点云。每个点仅保留 XYZ 坐标,不输入 RGB;随后用预设空间包围盒裁掉无关区域,再通过最远点采样(FPS)保留 512 或 1024 个点。
这几步各有用途。裁剪限制了策略需要解释的空间范围;FPS 用有限点数覆盖剩余几何结构,减少采样随机性;去掉颜色则降低对纹理和颜色的依赖。最终网络看到的是一个大小为 的坐标集合,而不是原始深度像素网格。
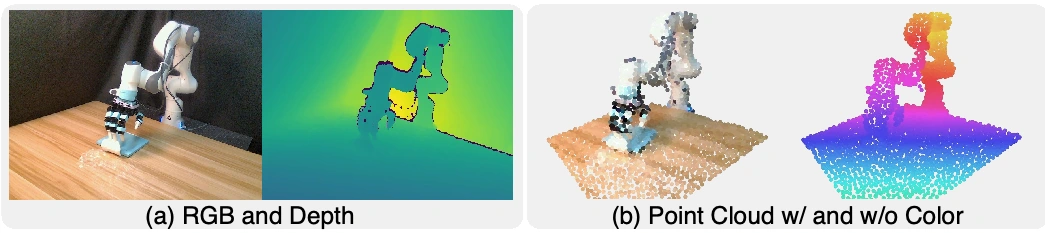
关键区别在于几何关系怎样表达。深度图里的相邻像素未必属于相邻表面,同样的像素位移也可能对应不同的空间距离;转换为点云后,三维位置关系可以直接由坐标表达。模型仍需学习哪些位置和形状会影响动作,但无需完全依赖二维纹理去推断这些关系。
点云没有替策略解决所有感知问题。它只包含单个视角能看到的表面,遮挡和深度缺失仍然存在;坐标也依赖标定与变换。输入三维坐标,更不意味着网络自动具备平移或旋转不变性。
编码器为什么这么小,还能保留控制所需的信息?
DP3 Encoder 对每个点应用共享 MLP,维度依次为 ,每层线性变换后接 LayerNorm 和 ReLU。然后在点的维度上取最大值,最后用 Linear 和 LayerNorm 把 256 维全局特征投影为 64 维:
这里的最大池化按特征通道独立进行:不同通道的最大值可以来自不同的点。它把点的数量消去,并使最终表示对输入点的排列顺序保持不变。共享 MLP 本身保留逐点输出的对应关系,真正得到全局排列不变表示的是池化步骤。
这个结构没有显式建立局部邻域,也没有逐点自注意力。它的归纳偏置比较直接:先从绝对坐标提取逐点特征,再聚合场景中响应最强的几何信息。对于需要根据物体与机器人相对位置采取动作的任务,保留位置相关信息有实际意义。物体识别往往希望同一物体换个姿态仍被识别为同一类,控制策略却需要让不同姿态对应不同动作,两类任务未必需要同样的特征变换。
机器人状态由另一个 MLP 编码,结构是 ,中间使用 ReLU。它与视觉特征共同决定动作:同一场景下,机械臂已经靠近物体还是仍在远处,下一步控制量当然不同。单个观测的联合特征是 128 维,历史观测的信息再作为去噪网络的条件。
空间泛化的证据是什么?
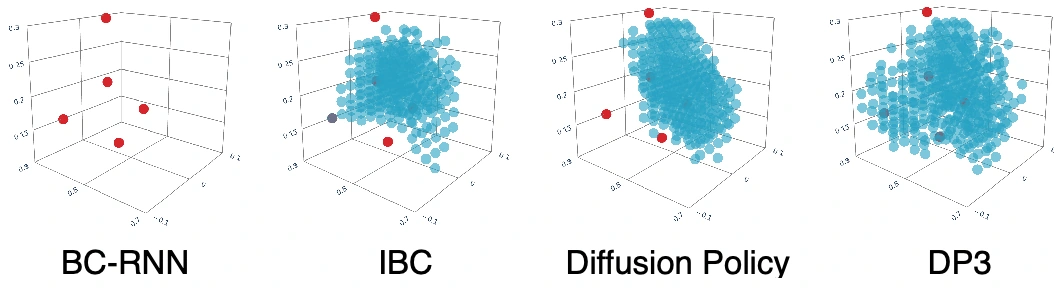
Reach 实验给了一个直观例子:只用 5 条示范训练,在三维空间测试 1000 次,BC-RNN、IBC、Diffusion Policy 和 DP3 分别成功 0、285、327、415 次。DP3 的成功位置覆盖了更广的空间,但其成功率仍是 41.5%。这个结果支持“点云表示有助于少样本空间外推”,并没有证明策略已能在整个工作空间可靠泛化。
动作生成:训练预测干净动作,推理执行短动作块
感知部分回答“根据什么行动”,扩散模型回答“生成怎样的一段连续动作”。DP3 使用基于卷积网络的条件去噪模型,同时更新整个动作序列,无需逐个动作自回归生成。
设归一化后的专家动作块为 ,扩散噪声等级为 。为了说明实际使用的 sample prediction,可以把训练过程写成:
表示两帧观测形成的条件信息, 表示噪声等级,与机器人执行的物理时刻 不同。训练要求网络从带噪动作中恢复原始动作块,目标可写为 。
原文公式 (2) 使用了预测噪声的写法,但 Implementation Details 明确说明,实际采用 sample prediction,即直接预测干净动作。两者都属于扩散模型的参数化方式;解读实现时,需要以实际采用的目标为准。Figure 7 显示 sample prediction 通常收敛更快,去掉它后的六任务平均分从 63.2 降至 59.0;epsilon prediction 仍能学到策略,不能将它描述为失效。
部署时,模型从高斯噪声开始,用 DDIM 做 10 次去噪更新,得到动作块;训练噪声调度则包含 100 个时间步。这里的“10 步”是一次策略查询内部的计算迭代,和下表里的动作执行长度是两回事。
| 参数 | 论文设置 | 含义 |
|---|---|---|
| 观测长度 | 2 | 每次查询使用两个时刻的观测 |
| 预测长度 | 4 | 一次生成长度为 4 的动作序列 |
| 执行长度 | 3 | 执行时间对齐后的最后 3 个动作,再接收新观测 |
| 训练 / 推理扩散步数 | 100 / 10 | 噪声调度长度与 DDIM 去噪迭代数 |
所以,H=4 不能直接理解成“从当前时刻开始,未来 4 步全部开环执行”。策略执行短动作段后重新查询,历史观测和预测序列之间还需要保持时间对齐。论文也比较了较长配置 :六任务上 DP3 从 63.2 变为 64.2,短窗口并未明显损失整体表现,因此作者选择较短窗口来保留对环境变化的响应机会。
复现时还有一个容易漏掉的细节:附录要求把各动作维度和观测维度按各自最小、最大值缩放到 。作者特别强调动作归一化,因为所用 DDPM/DDIM 实现会把预测裁剪到这个区间。若直接用未归一化的物理控制量训练,再让采样器执行裁剪,动作幅度就可能被破坏。
消融实验:收益来自几何、编码器,还是扩散模型?
这一节的对比都应先确认任务集合。论文主要消融只使用 Adroit 的 Hammer、Door、Pen,以及 MetaWorld 的 Assembly、Basketball、Shelf Place,共 6 个任务,每项 10 条示范;它们的平均分不能直接当成 72 项主实验的平均成绩。
深度信息有用,但表示形式同样重要
保持动作模型为扩散策略,更换视觉表示及相应编码器,v1 Table IV 得到:
| 视觉表示 | RGB 图像 | RGB-D | 深度图 | 体素 | 点云(DP3) |
|---|---|---|---|---|---|
| 六任务平均分 | 28.7 | 27.8 | 42.0 | 39.5 | 63.2 |
深度图比 RGB 更好,但仍明显低于点云。这个对比支持点云及其编码方式的价值,同时需要看到:实验替换了表示,也替换了编码器,并非只隔离了输入数据格式这一个变量。
“二维基线分辨率太低”也不能完整解释差距。Table IX 将 RGB 基线从 提高到 和 ,六任务平均分分别为 28.7、30.2、29.5,仍低于 DP3 的 63.2。这只排除了所测配置下单纯提高像素数的解释,不代表二维视觉已经没有改进空间。
更强的通用点云编码器,未必更适合这组控制任务
把视觉输入固定为点云,替换编码器,v1 Table V–VI 的部分结果如下:
| 编码器或改动 | 六任务平均分 |
|---|---|
| DP3 Encoder | 63.2 |
| PointNet | 17.7 |
| PointNet 去掉 T-Net 与 BatchNorm | 59.5 |
| PointNet++ / PointNeXt / Point Transformer | 2.2 / 2.3 / 1.0 |
| 预训练 PointNet++ / 预训练 PointNeXt | 6.8 / 8.8 |
最有解释力的结果是 PointNet 的逐项改造:去掉 T-Net 和 BatchNorm 后,成绩从 17.7 接近到 59.5。作者认为,固定相机下的控制任务未必需要 T-Net 提供的特征变换;但论文没有定位其他复杂编码器失败的完整原因。因此,更稳妥的结论是“面向识别或分割设计的表示,不能未经验证就当作合适的控制表示”,而不是“网络越小越好”或“预训练无用”。
其他设计也不应统称为成功率改进。Table VII 中,去掉点云裁剪使平均分从 63.2 降至 51.3,影响较大;去掉 LayerNorm 为 61.3,去掉投影头为 62.2。加入颜色反而得到 63.7,与默认配置接近。去颜色的主要取舍是降低外观依赖,投影头的主要用途是压缩特征与加快推理,二者都没有被证明必然提高原任务成功率。
三维表示也不能替代动作建模。另一组 10 任务对比中,BCRNN 加入 DP3 Encoder 后平均分从 1.8 升到 18.8,IBC 从 5.2 升到 18.7;同一组任务上的 DP3 为 65.3。点云能帮助其他策略,但“点云加任意动作头”并没有复现 DP3 的结果。
主实验怎么读:示范数量、评估方法和例外都重要
v1 的 72 项仿真实验覆盖 7 个任务域,既包含夹爪操作,也包含最高 52 维动作控制。除 DexDeform 使用人类遥操作数据外,其余域主要由强化学习专家生成成功轨迹,同一任务的不同方法使用相同示范。
| 任务域 | 任务数 | 每任务示范数 | Diffusion Policy | DP3 |
|---|---|---|---|---|
| Adroit | 3 | 10 | 31.7 | 68.3 |
| Bi-DexHands | 6 | 10 | 61.3 | 70.2 |
| DexArt | 4 | 100 | 49.0 | 68.5 |
| DexDeform | 6 | 10 | 90.5 | 87.8 |
| DexMV | 2 | 10 | 95.0 | 99.5 |
| HORA | 1 | 100 | 49.0 | 71.0 |
| MetaWorld Easy | 28 | 10 | 59.7 | 90.1 |
| MetaWorld Medium | 11 | 10 | 26.9 | 61.0 |
| MetaWorld Hard | 6 | 10 | 9.8 | 43.2 |
| MetaWorld Very Hard | 5 | 10 | 17.8 | 56.6 |
| 全部任务 | 72 | 其中 67 项使用 10 条 | 47.6 | 73.9 |
表中数值照录 v1 Table I,MetaWorld 按原表分成四个难度组。HORA 使用归一化回报,其余主要使用成功率,所以跨 72 项的平均值严格说是论文报告的汇总指标。原文报告整体从 47.6 到 73.9,增加 26.3 个百分点,相对提升约 55.3%;DexDeform 则略有下降,不能概括成每个域都提升。
评估协议同样影响数字的含义:每项实验运行 3 个随机种子,每隔 200 个 epoch 评估 20 个 episode,取最高 5 次评估成绩的平均,再汇总不同种子。它反映训练过程中多次评估后的较好表现,不能与只测最终 checkpoint 一次的结果直接混比。
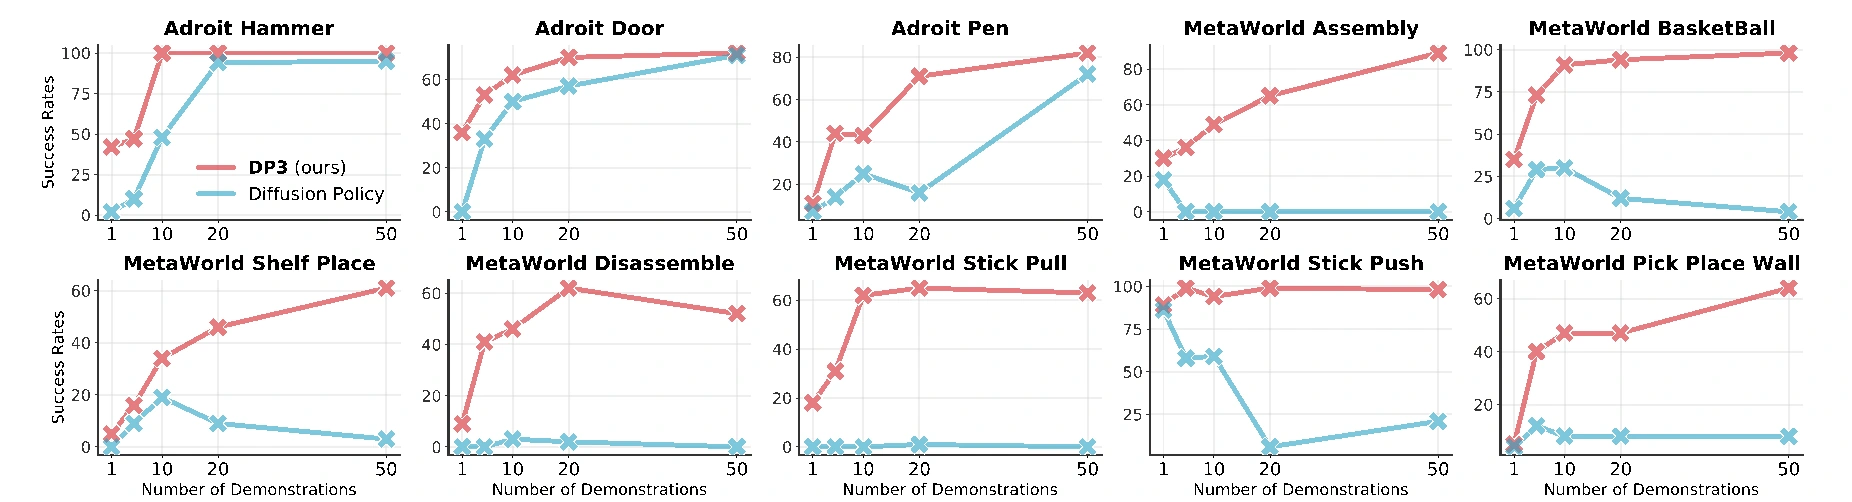
“数据效率高”还包含两个不同观察。Figure 5 中,DP3 通常收敛更快;Figure 6 中,DP3 在若干任务上用较少示范就达到较好的表现。更快收敛衡量的是训练过程,少样本表现衡量的是数据需求,二者不应合并成一个含糊的“更高效”。这里也没有直接证明成功轨迹之外的失败示范、不同质量的人工示范会带来同样收益。
真实机器人与泛化:85% 是怎样得到的?
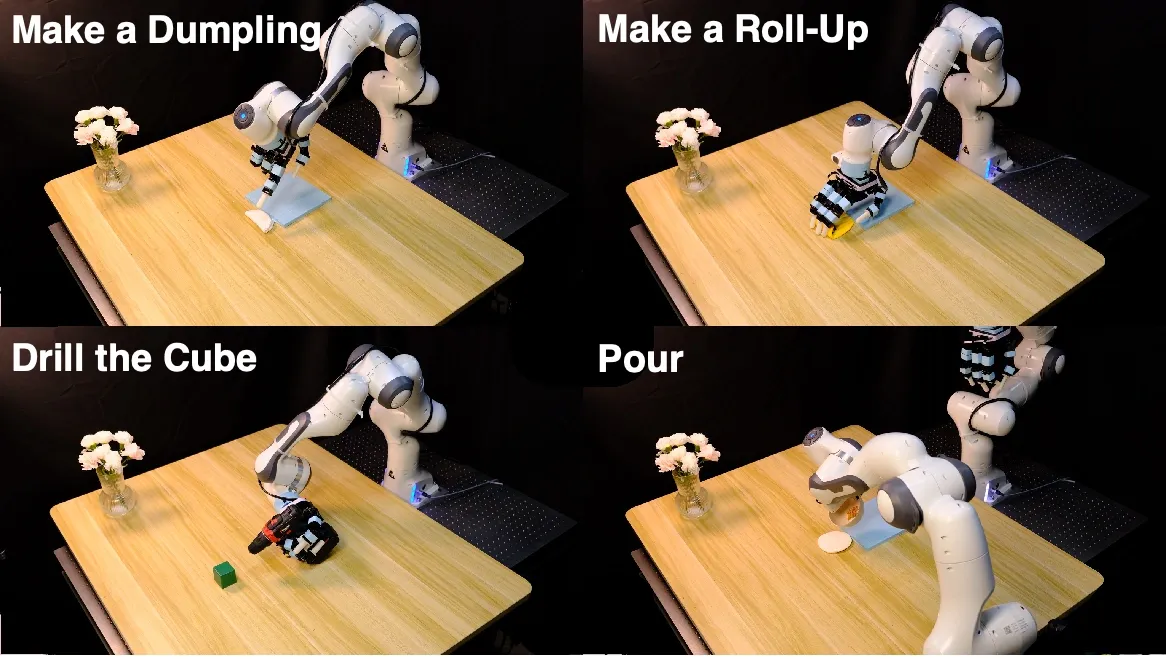
真实实验使用 Franka 机械臂搭配 Allegro 灵巧手或平行夹爪,以 RealSense L515 获取深度观测。每个任务收集 40 条人类遥操作示范,测试 10 次。前三项任务的动作维度为 22,Pour 为 7。
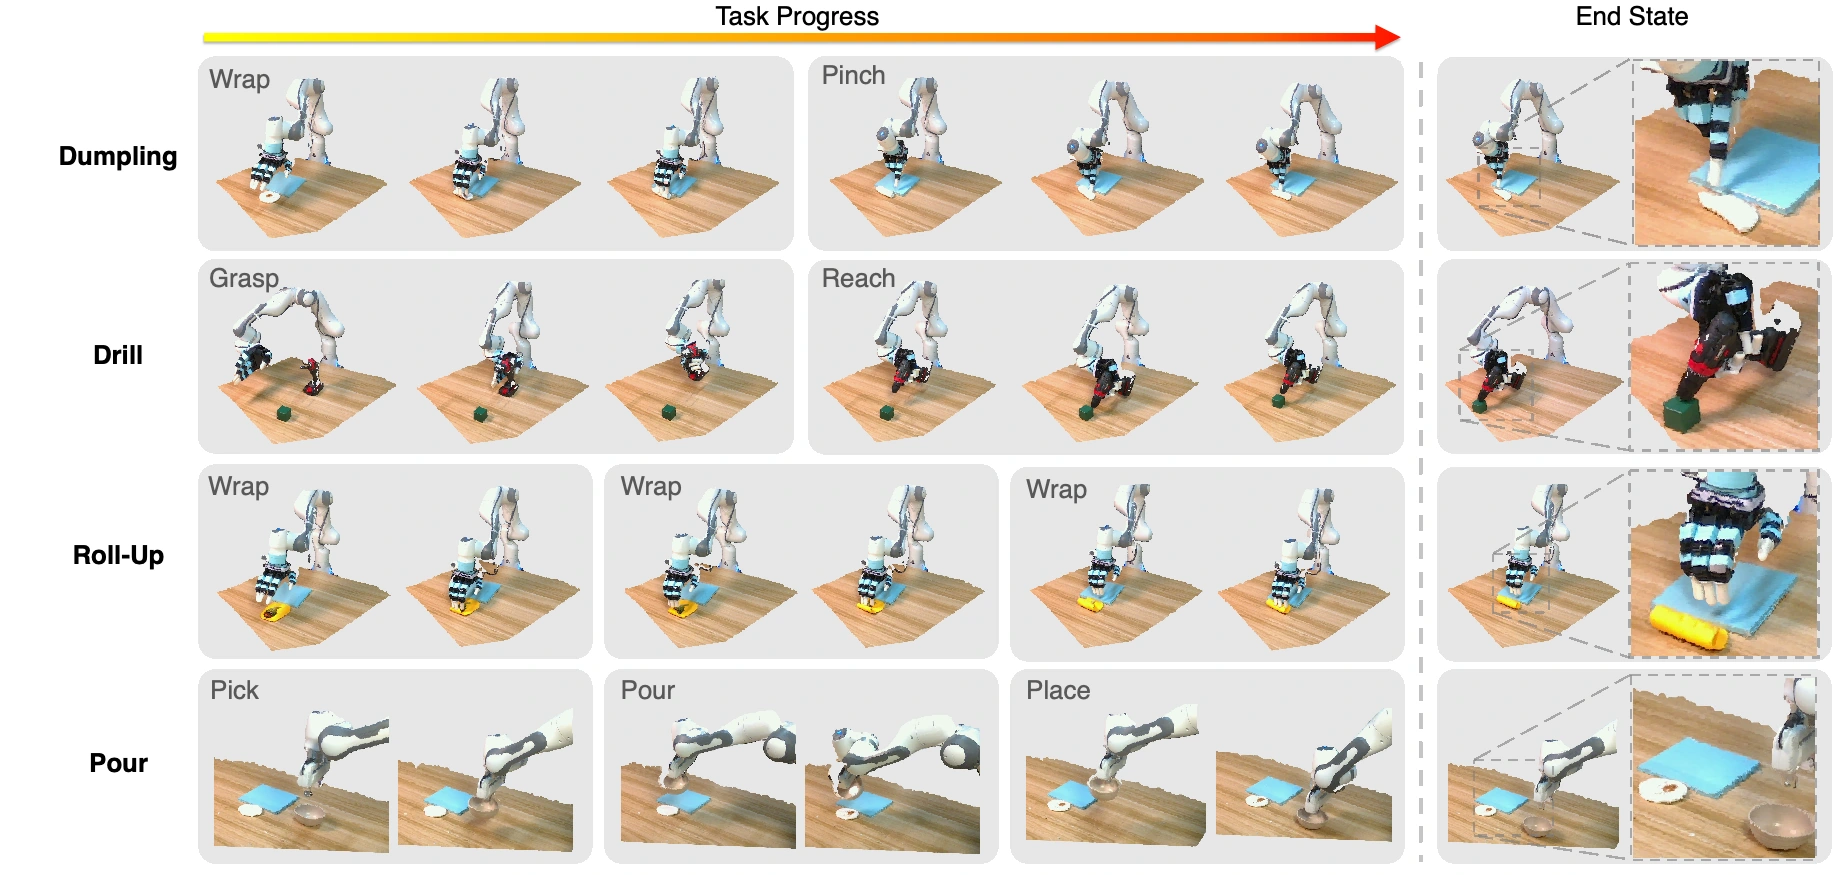
| 方法 | Roll-Up | Dumpling | Drill | Pour | 平均 |
|---|---|---|---|---|---|
| RGB Diffusion Policy | 0% | 30% | 70% | 40% | 35% |
| 深度图 Diffusion Policy | 40% | 20% | 10% | 10% | 20% |
| DP3 | 90% | 70% | 80% | 100% | 85% |
这张表最直接的含义是:在相同示范数量下,DP3 在四个任务上都能取得较好的结果,且两个二维基线各有擅长和失效的任务。它并不说明深度图在所有任务中都优于 RGB,也不说明 85% 可以外推到任意操作任务。每项只有 10 次测试,一次成败就对应 10 个百分点。
泛化测试进一步改变训练条件之外的位置、外观、实例或视角,但每个新条件都只试一次:
| 泛化类型 | 实际改变的条件 | DP3 的观察结果 |
|---|---|---|
| 空间,Pour | 碗放在 5 个训练外位置 | 成功 4/5,两个基线均为 0/5 |
| 外观,Drill | 将绿色目标方块换成 5 种颜色 | 成功 5/5,两个基线均为 0/5 |
| 实例,Drill | 用鼠标、玩具、杯子等 5 个物体替换目标方块 | 成功 5/5 |
| 视角,Roll-Up | 相机轻微改变至 3 个新视角 | 成功 3/3;手动调整了点云裁剪范围 |
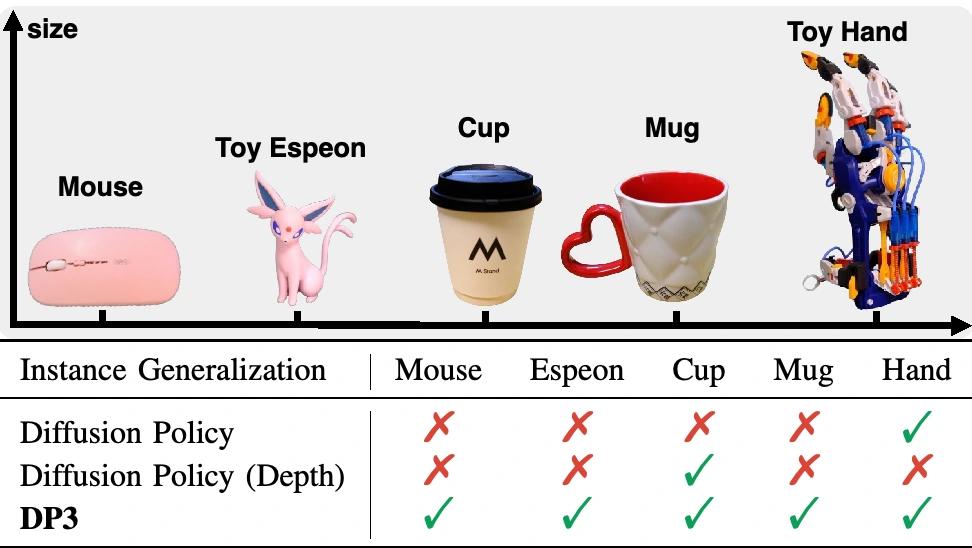
这里有两条边界尤其影响解读。实例泛化测的是“持电钻接触不同目标”,并未检验能否抓稳不同型号的电钻。视角泛化则包含人工调整裁剪范围,不能等同于在任意相机位置上直接部署。这些单次测试展示了成功案例,还不足以估计各条件下稳定的成功概率。
论文还统计了需要人为终止、以避免硬件损坏的安全违规:RGB 策略平均为 32.5%,深度图策略为 25%,DP3 为 0%。这是上述真实实验中的观察,模型没有因此获得安全约束或形式化保证。它提示更合适的观测表示可能改善控制行为,但不能取代部署时的硬件保护。
对复现与后续研究有什么启发?
DP3 的证据支持一个具体判断:在这些少样本操作任务里,显式几何坐标、适合控制的小型点云编码器和扩散动作生成结合起来,比论文比较的二维策略更有效。它的收益不能单独归给深度传感器,也不能用一个“更复杂的模型”来解释。
复现应先核对数据链路:深度到点云的标定与坐标变换是否一致,裁剪是否保留了任务所需的物体和机器人,采样点数和颜色通道是否匹配,动作是否正确归一化,历史观测与执行切片是否对齐。这些设置会改变策略实际看到和执行的内容,优先级往往高于直接更换编码器。
方法的取舍也很清楚。稀疏单视角 XYZ 能减少外观干扰,却缺少遮挡表面、颜色语义与触觉接触信息;64 维全局池化特征计算便宜,但论文没有证明它保留了所有精细接触所需的局部结构。作者还明确指出,极长时程任务没有在本文中展开。把 DP3 用到依赖颜色选择目标、严重遮挡或多阶段长任务时,需要重新检查观测与任务是否匹配,不能只照搬原实验的平均分。
资料与配图来源
正文的方法、超参数及表格均以 arXiv:2403.03954v1 为依据。封面取自该版 Figure 1 的真实任务区域,正文图片取自 Figure 2、3、6、10、11 及 Table XIII,仅裁剪图外内容,图内数据与标注未改写。
现行 v7 论文与项目主页可用于查阅后续版本和演示;官方代码仓库提供实现。理解其扩散动作模型时,可结合 Diffusion Policy 原论文与项目阅读。图片与研究成果归原作者所有。