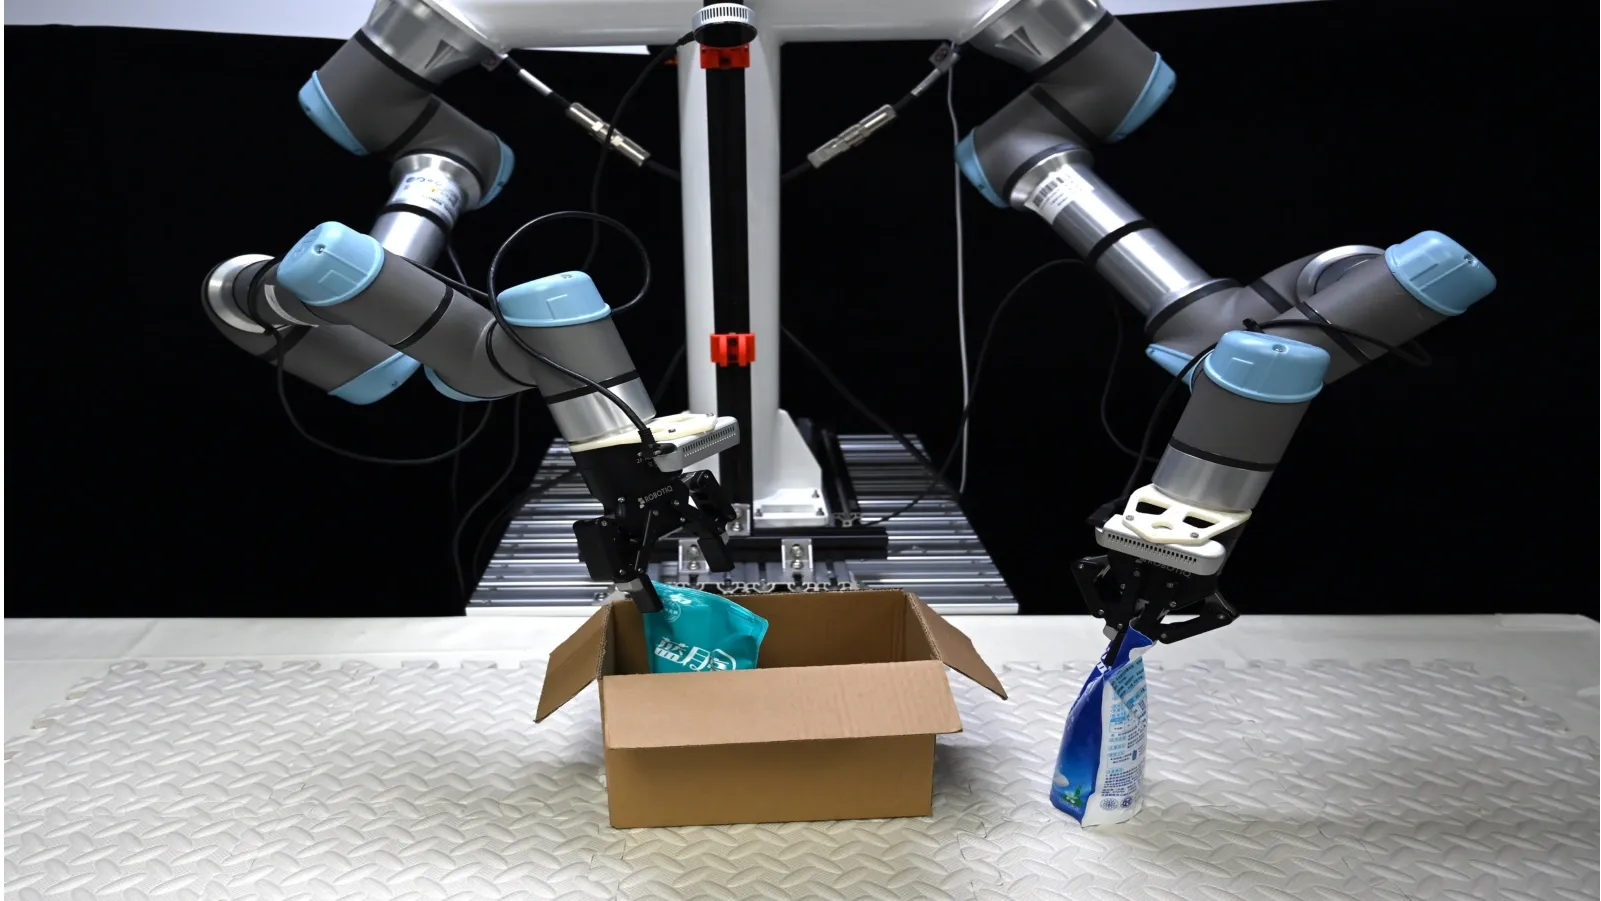
论文精读|DexVLA:先练动作专家,再接入视觉语言模型
论文: DexVLA: Vision-Language Model with Plug-In Diffusion Expert for General Robot Control
作者: Junjie Wen、Yichen Zhu、Jinming Li、Zhibin Tang、Chaomin Shen、Feifei Feng
发表: CoRL 2025;本文对应 arXiv v3,修订于 2025 年 8 月 9 日
论文 v3 · 项目与演示视频
视觉语言模型能理解“把衣服叠好”,但把指令变成连续、协调的双臂运动,还需要学到机器人自己的动作知识。DexVLA 把主要改进放在动作端:先用机器人数据单独预训练一个十亿参数的扩散动作专家,再把它接到视觉语言模型上,逐步完成本体对齐与任务适配。
这套方法还有一个与长任务直接相关的设计:让模型自己生成“取出衣服、铺平、折叠、堆放”等子步骤,并用这些表示指导动作。扩散生成动作序列、多视角输入等沿用已有思路,本文重点看动作专家为什么值得单独训练,以及它怎样与语言推理配合。
动作专家怎样接入视觉语言模型?
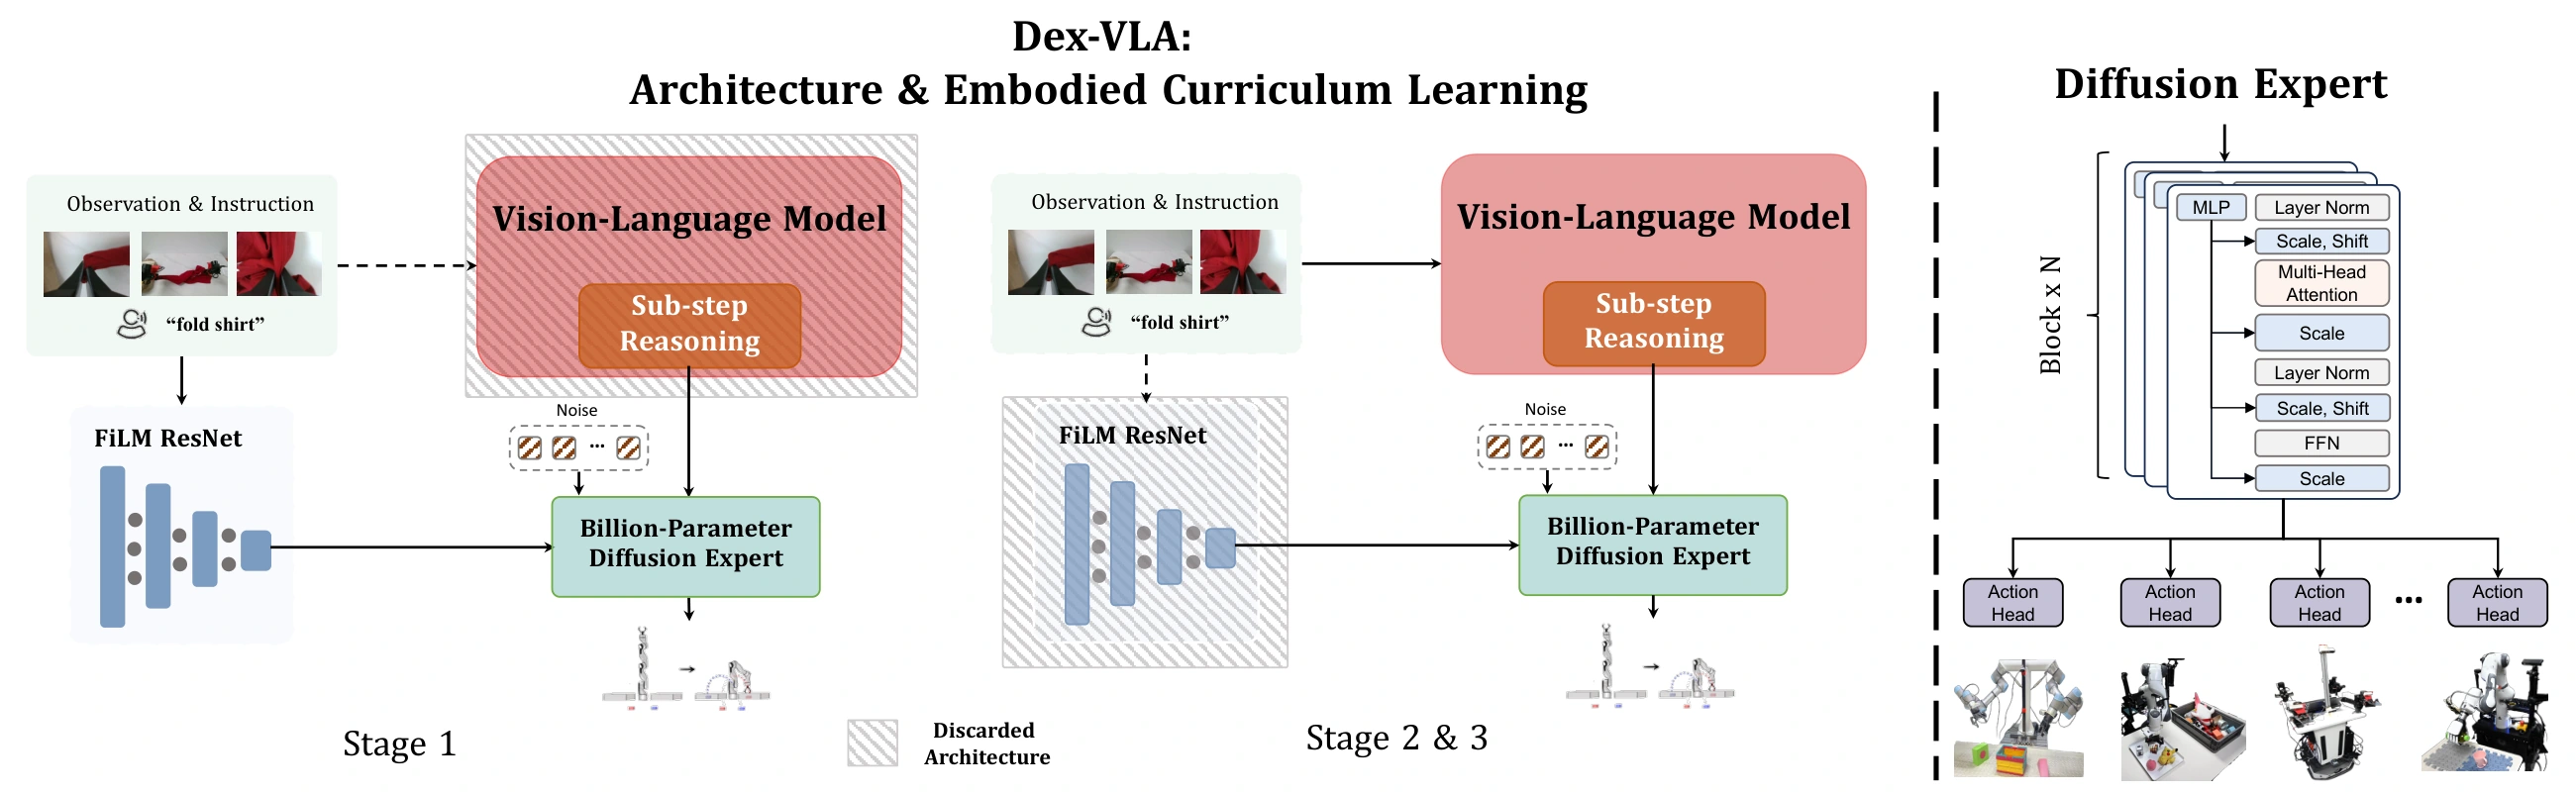
完整模型使用 Qwen2-VL 2B 作为视觉语言骨干,配合一个 1B 参数的动作专家。这里的十亿参数专指动作模块。专家基于 ScaleDP 的扩散 Transformer,从噪声中逐步生成连续动作序列。
不同机器人共用扩散主干,各自使用一个 MLP 动作输出头。这样,单臂、双臂等数据可以一起训练,而不同的动作维度和控制空间由对应输出头处理。共享的是动作模型的内部表示,输出端仍然保留机器人之间的差异。
VLM 与动作专家之间有两路联系。VLM 输出的动作 token 经过两层线性映射和 LayerNorm,转成动作专家需要的条件表示;推理 token 则通过 FiLM 调制策略特征,让当前子步骤影响动作生成。最终控制量由扩散专家产生,不能把这里的动作 token 直接当成离散化的关节命令。
“Plug-in”对应这种可拆分、可对接的模块结构。要让语言表示真正对应机器人的动作,仍然需要下面的对齐训练。
为什么先练动作,再做本体对齐?
DexVLA 将训练分成三个阶段,每个阶段解决的问题不同。
第一阶段:跨本体预训练动作专家。 暂时不接入大 VLM,用 ResNet-50 编码图像、DistilBERT 编码语言,再训练共享扩散主干和各本体的动作头。数据约 100 小时,覆盖四种本体、91 项任务。专家先在较轻的感知接口下学习动作,避免一开始就联合优化整个 VLA。这里没有去掉视觉与语言条件,只是暂时使用较小的编码器。
第二阶段:接入 VLM,针对目标机器人对齐。 移除第一阶段的临时图像、语言编码模块,换成 Qwen2-VL 提供条件;筛选目标本体的数据,联合训练语言模型、投影层和动作专家,同时冻结 VLM 的视觉编码器。模型由此学习相机观测、语言表示与该机器人控制空间之间的对应关系。论文所说的“无需任务专门适配”,就是在完成这一阶段后评估,仍然用过该本体的数据。
第三阶段:用高质量示范适配具体任务。 对更长、更依赖精细操作的任务继续后训练,也用来学习新本体上的技能。已经能完成的简单任务可以停在第二阶段;从一篮揉皱衣服开始整理的 Laundry Folding,则需要第三阶段。
消融直接说明了训练顺序的作用。Table 2 中,只做第二阶段、不预训练动作专家时,平铺衣物折叠得分为 0;先做第一阶段再对齐,得分达到 0.92。长任务 Laundry Folding 在前两阶段后仍为 0,加入第三阶段后才达到 0.40。这些结果支持分阶段训练的必要性,但只对应论文测试的折叠任务。
拆开训练也减少了第一阶段的开销。相同 batch size 下,仅训练动作专家每小时完成 0.89 个 epoch,训练整个 VLA 为 0.32 个,吞吐约为后者的 2.78 倍。这个数字描述的是第一阶段的训练速度,不是整套方法的总成本降幅。
子步骤推理怎样影响动作?
“叠好篮子里的衣服”覆盖了很不一样的状态:衣服还在篮子里、已经摊到桌上、袖子需要调整、折好后等待堆放。仅用一句总指令监督所有动作,模型容易跳过中间步骤。
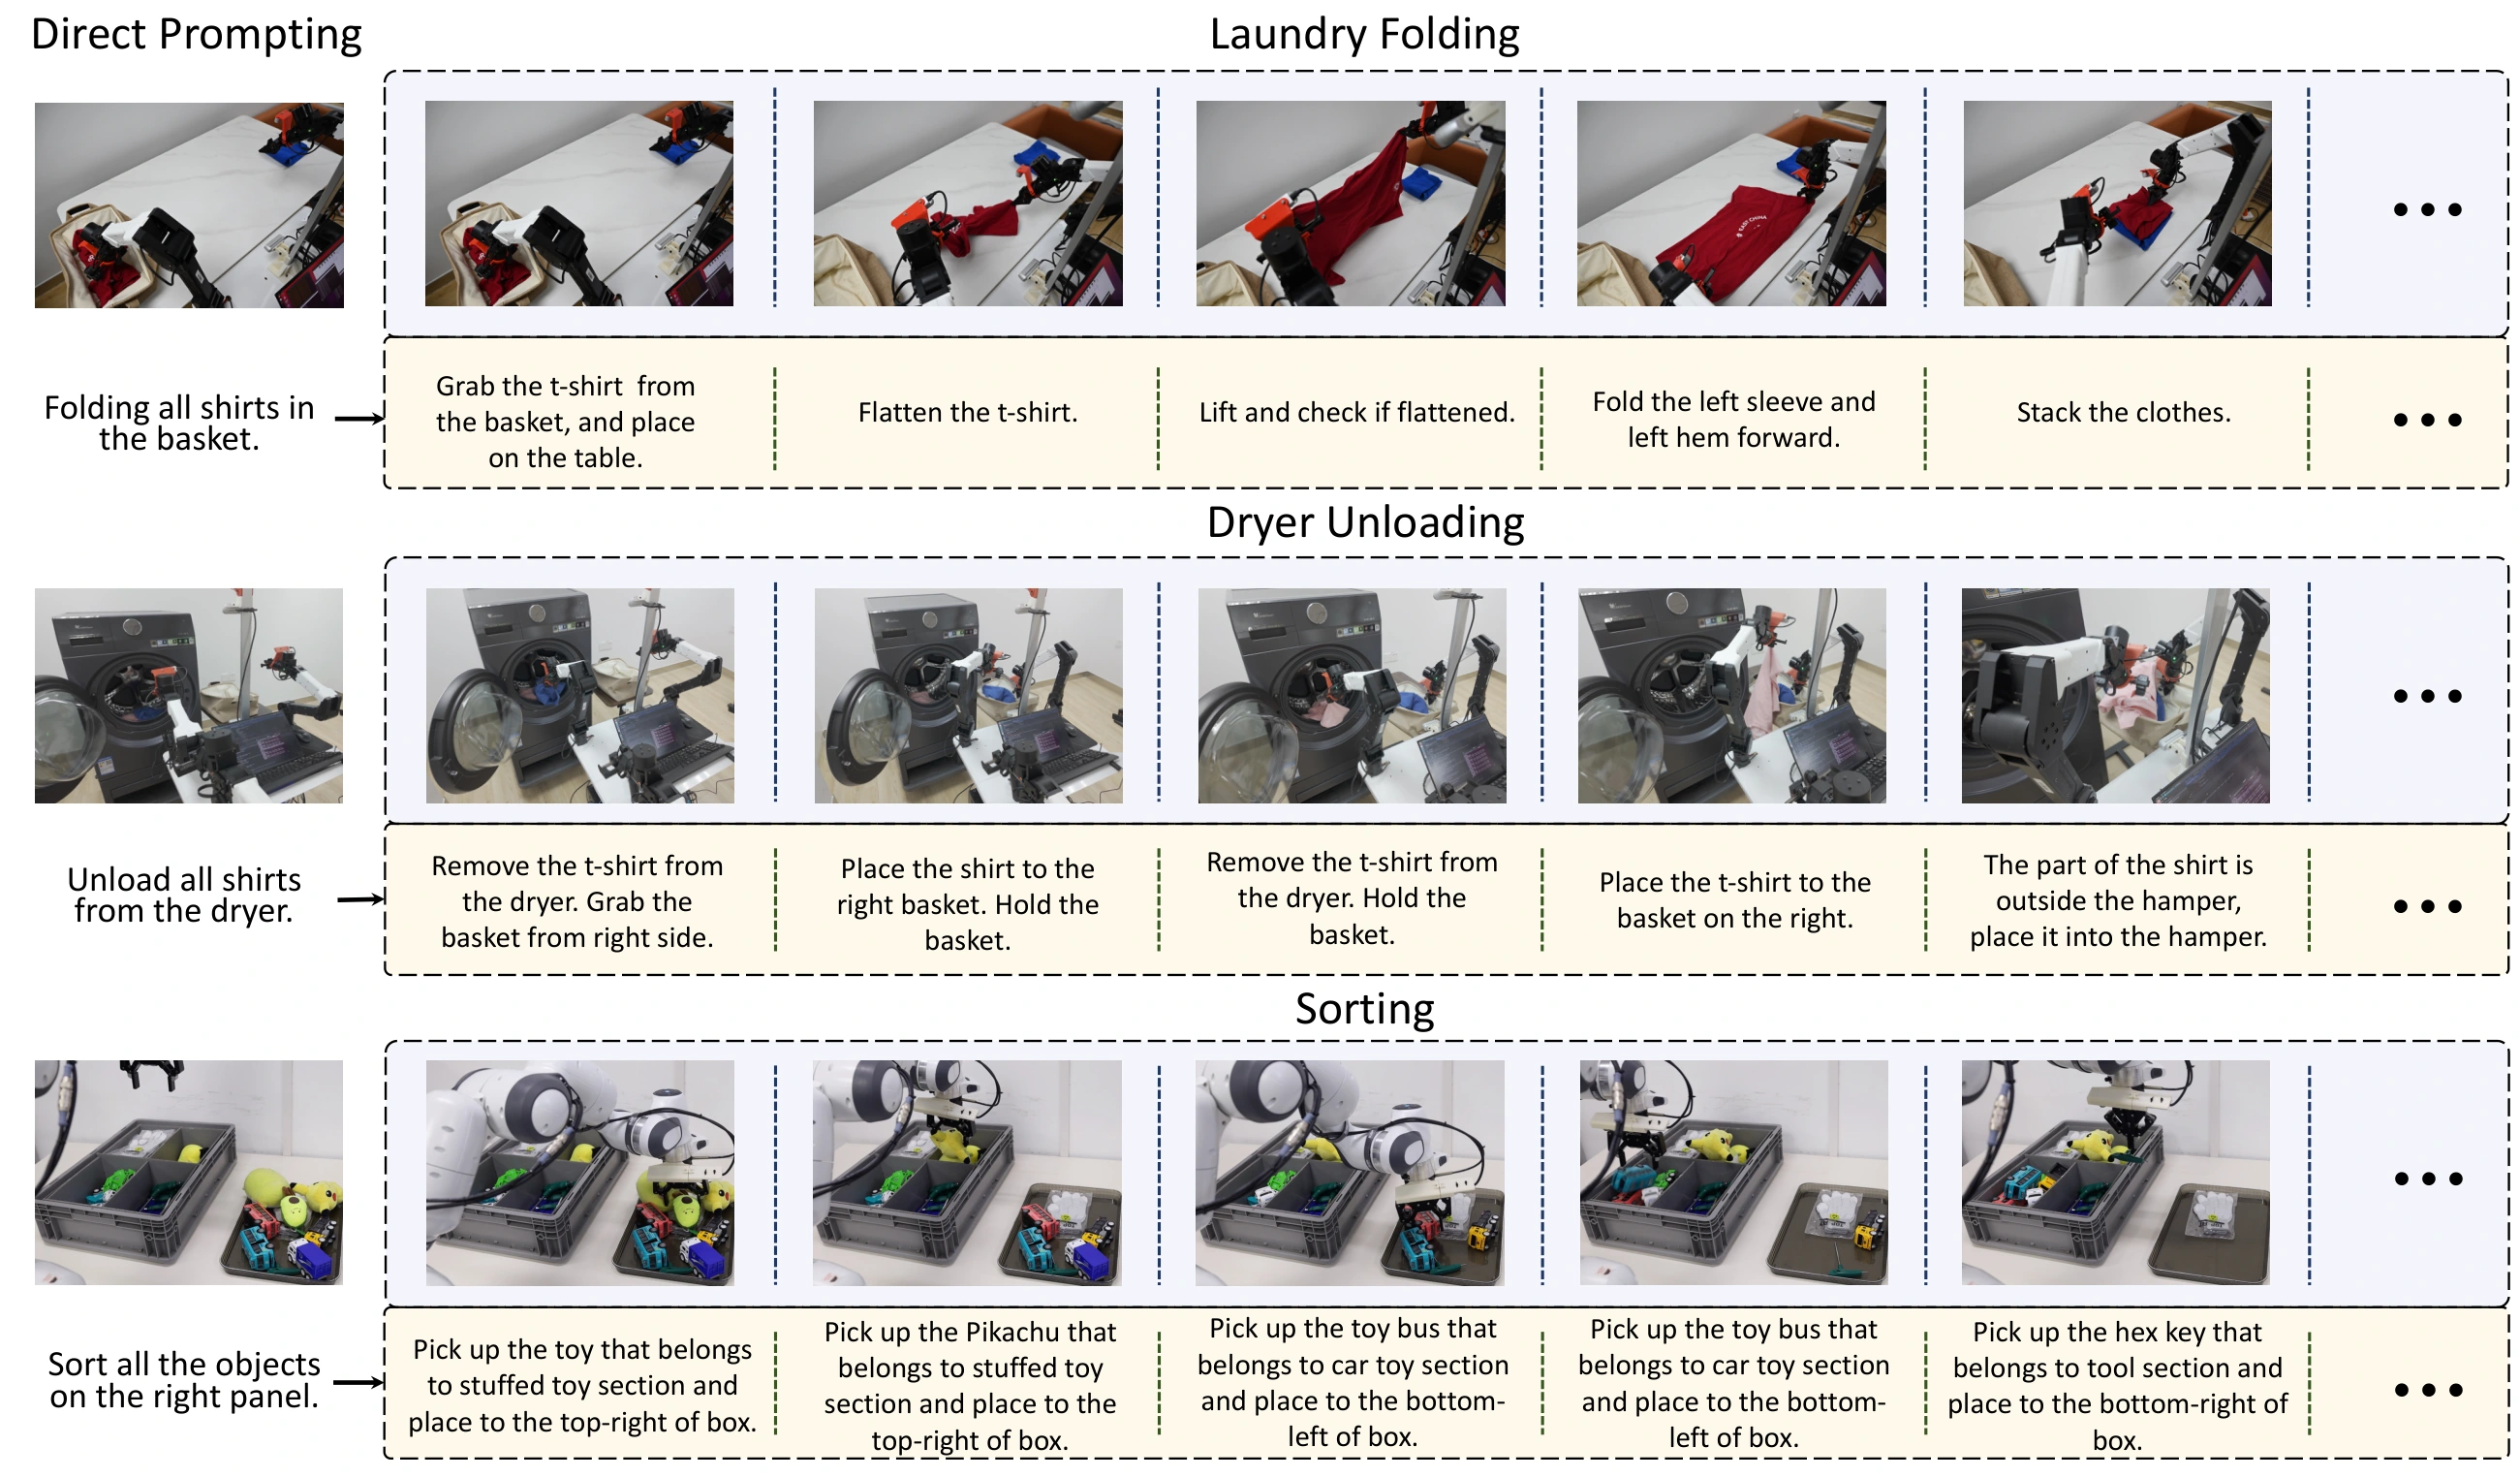
DexVLA 在训练示范中加入子步骤标注,主要步骤通常持续约五秒或更久。第一阶段先用这些语言条件训练动作专家;第二、三阶段则把子步骤描述作为模型需要生成的中间语言输出,而不是每次由外部直接给出下一条子指令。训练同时优化扩散动作预测与语言 token 预测,生成的推理表示再经 FiLM 进入策略。
因此,部署时只给总指令,模型需要结合当前画面判断接下来做什么,不依赖额外的高层规划器持续派发子任务。这种能力有明确的监督来源:附录使用目标检测、视觉特征和 Gemini 2.0 辅助标注,并对第三阶段数据人工核查。
子步骤监督的贡献很大。Table 7 中,第一、二阶段都使用它时,平铺衣物折叠得分为 0.92;第一阶段只用总指令、第二阶段才加入子步骤监督时,降到 0.07。只在 VLM 对齐时再加入子步骤语言,难以补回动作预训练阶段的差距。
作者将这一现象解释为:子步骤帮助区分不同动作模式,减少多任务之间的干扰。实验支持子步骤监督有效,但“内部参数如何分工”仍属于解释,没有被这些得分直接验证。
哪些结果最能说明它的价值?
真实机器人实验主要报告按任务阶段计分、归一化后的平均得分,每项任务、每种方法评估 10 次。例如 Laundry Folding 按取出、铺平、折叠、堆放四个阶段给分,所以 0.40 不能直接读成 40% 的整项任务成功率。
| 评估条件 | 任务 | DexVLA 平均得分 | 对照结果 |
|---|---|---|---|
| 完成第二阶段,无第三阶段适配 | 折叠已平铺的衣服 | 0.92 | DP、Octo、OpenVLA 均为 0 |
| 新本体,每项任务 100 条示范微调 | 双臂 UR5e 装箱 | 0.95 | DP 为 0.35 |
| 新本体,每项任务 100 条示范微调 | Franka 灵巧手倒饮料 | 0.85 | DP、Octo、OpenVLA 均为 0 |
第一行说明预训练与本体对齐已经能支持较复杂的技能,但任务并非从未出现在训练中。后两行的机器人配置未参与第一、二阶段训练,展示的是每项 100 条示范微调后的适应能力。
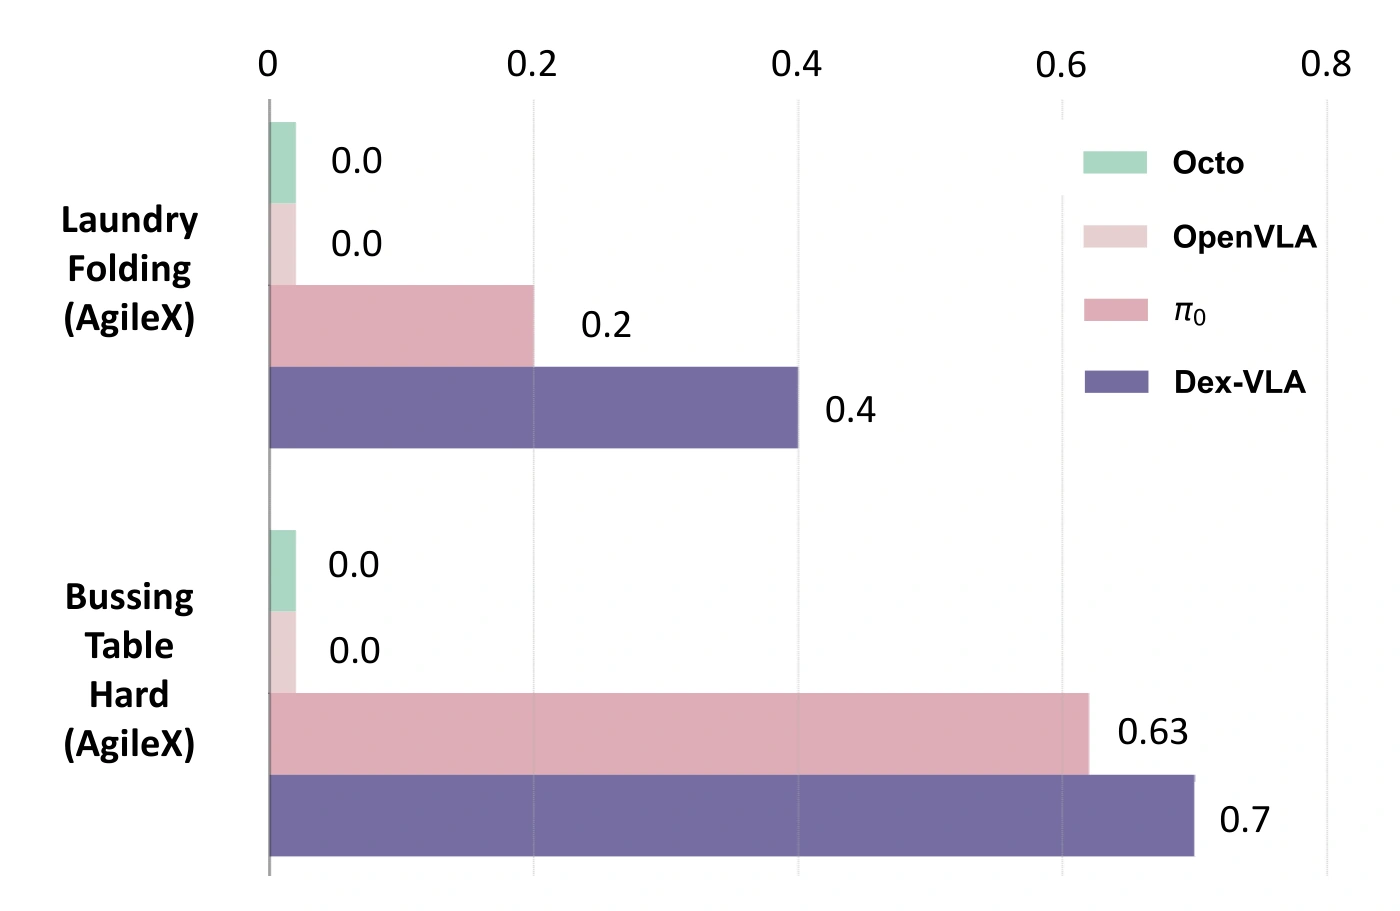
长任务更能体现子步骤推理的用途。从揉皱衣物开始整理的 Laundry Folding 中,DexVLA 得分 0.40,直接提示的 π₀ 为 0.20。这里比较的是都只接收总指令的设置,不能据此推断 π₀ 配合外部高层规划器时的表现。
动作专家的容量也有对应证据。Table 3 中,93M 的 U-Net、410M 的扩散专家和 1B 的扩散专家,在平铺衣物折叠上的得分依次为 0.17、0.63、0.92。其中 U-Net 到 Transformer 同时改变了架构与参数量;410M 到 1B 的比较,才更直接支持扩大同类动作专家的收益。
这篇论文值得带走什么?
DexVLA 最有参考价值的是训练组织方式:让动作专家先从机器人数据中学到可迁移的动作表示,再让 VLM 与目标机器人的控制空间对齐;子步骤监督贯穿两者,把长任务中的阶段差异带入动作学习。十亿参数动作模块、分阶段训练和语言监督是相互配合的设计。
结果也留下了清楚的边界。100 小时指机器人预训练数据,不包含 Qwen2-VL 已用过的视觉语言预训练数据;新本体的装箱、倒饮料实验仍需要各 100 条示范;最难的 Laundry Folding 得分也只有 0.40。它说明这条路线能够改善长任务控制,还没有证明开放环境下的可靠执行。
若要借鉴到自己的系统,优先值得检查的是:动作端是否有足够的预训练,语言与控制空间是否经过对齐,长任务示范是否标清了关键阶段。论文的消融表明,只把动作网络做大,或者只在末期加入子步骤语言,都不足以复现完整方案的效果。
原文与配图来源
本文依据所提供的 DexVLA.pdf(arXiv:2502.05855v3)撰写;数据对应 Figure 6、8、9,Table 2、3、6、7 及附录 C。封面截取 Figure 1 的装箱画面,正文配图来自同版本高清 PDF 的 Figure 2、3、9,仅裁切图外内容,图内数据未改写。图片与原始研究成果归原作者所有。版本与发表信息见论文页面,任务演示见作者项目主页。